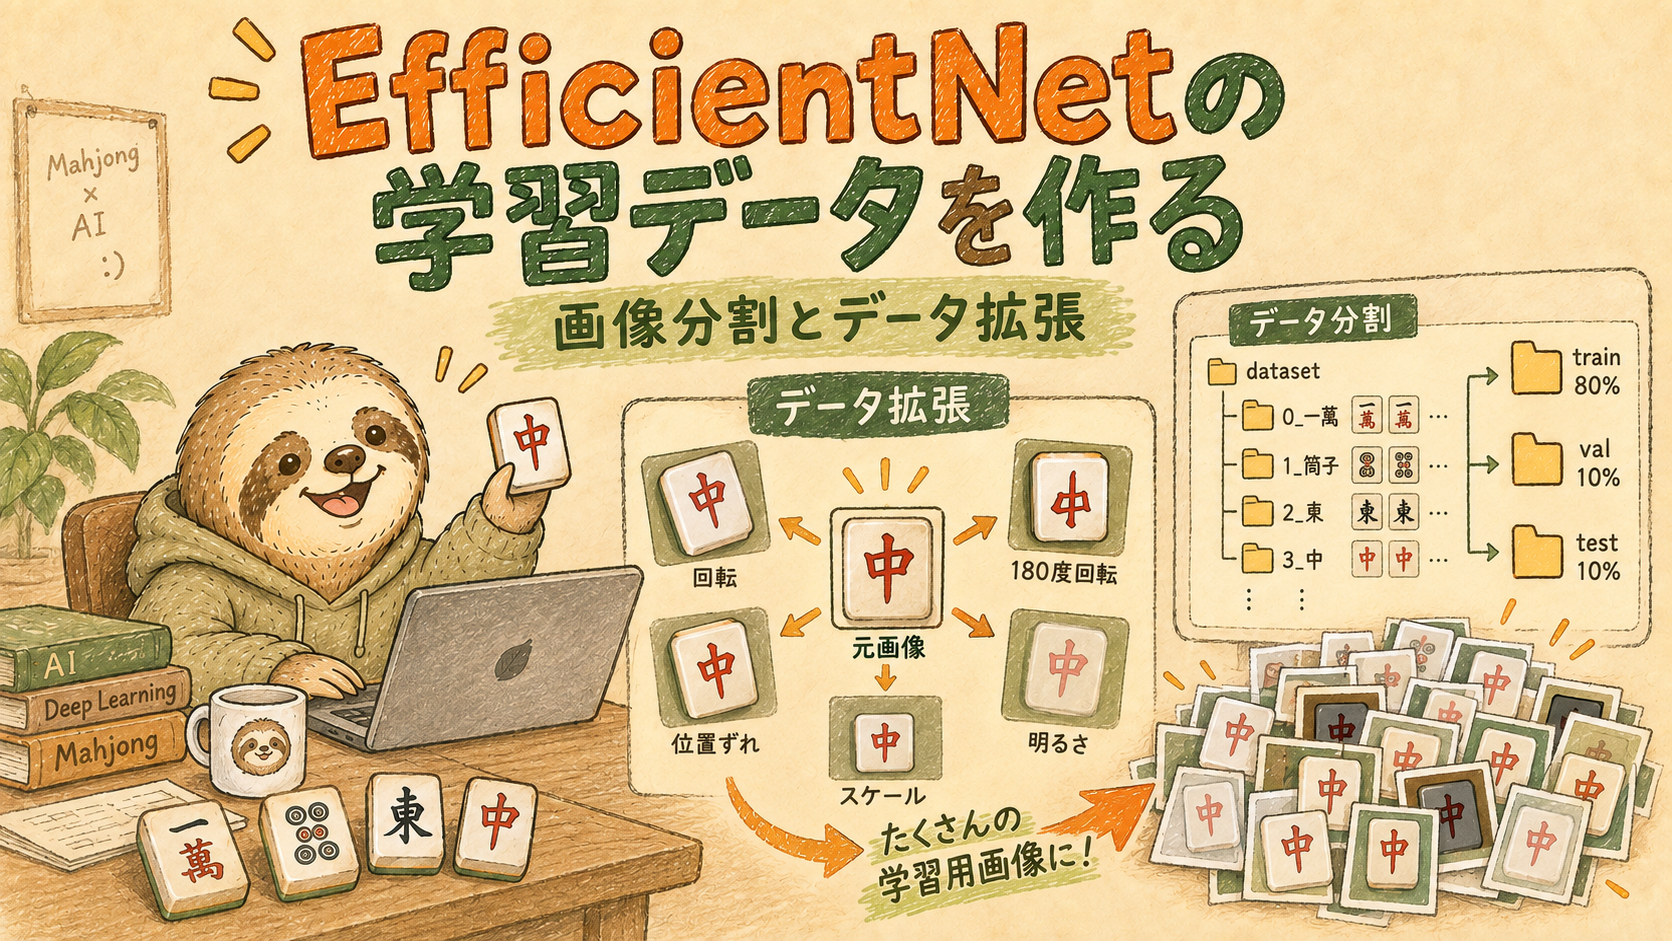
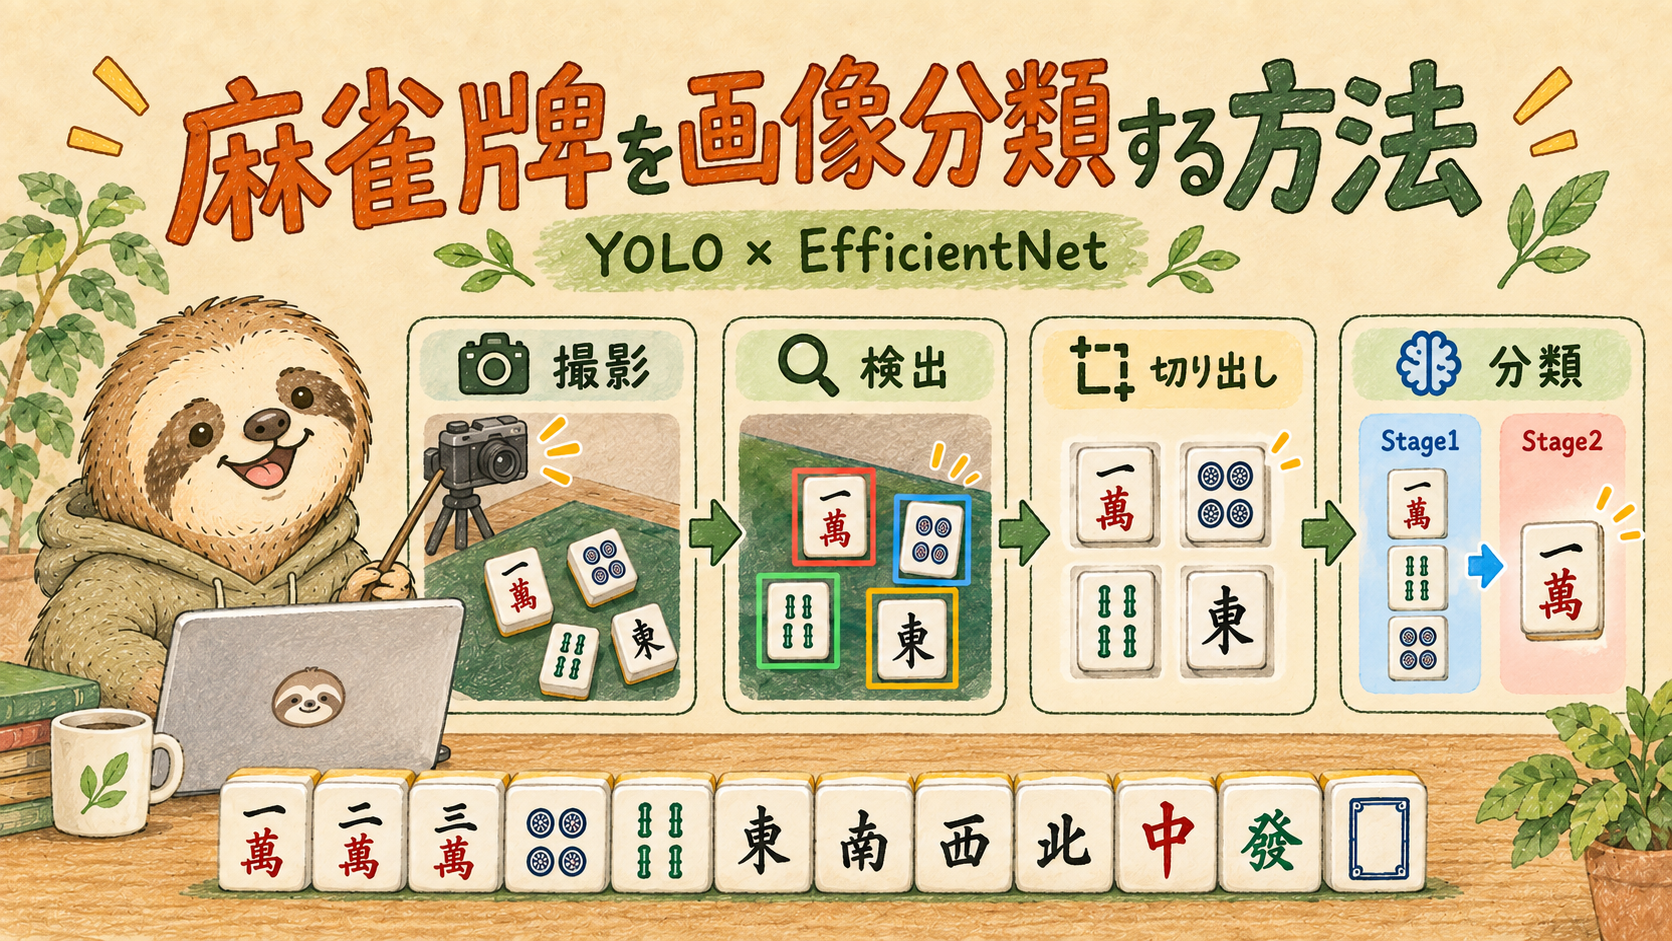
前回は、YOLOで検出した麻雀牌をEfficientNetで分類する全体の流れを紹介しました。
今回は、そのEfficientNetに学習させるためのデータセット作りを進めます。
画像分類モデルを作るときは、ただ牌画像を集めるだけでは足りません。
- 学習しやすいフォルダ構成に整理する
- train / val / test に分ける
- 足りない画像をデータ拡張で増やす
という準備が必要になります。
特に今回の麻雀牌分類では、データ拡張がかなり重要です。
麻雀卓の上で撮影した牌画像は、毎回まったく同じ条件にはなりません。
少し傾いたり、位置がずれたり、明るさが変わったりします。
そこで今回は、そうした実運用に近い揺らぎを入れながら、EfficientNet用の学習データを作っていきます。
使用するコードは次の2つです。
config.py の全文を見る
from datetime import datetime


# =========================
# サンプル設定
# =========================
TARGET_SAMPLE = [
    "./image_classification/01_data/20260627_123025",
    "./image_classification/01_data/20260710_120118",
    "./image_classification/01_data/20260714_214916",
    "./image_classification/01_data/20260722_194307",
    "./image_classification/01_data/20260725_133610",
    "./image_classification/01_data/20260729_214106",
    "./image_classification/01_data/20260729_215809",
]


# クラス一覧
CLASSES = [
    "0", "1", "2", "3", "4", "5", "6", "7", "8", "9",
    "10", "11", "12", "13", "14", "15", "16", "17", "18", "19",
    "20", "21", "22", "23", "24", "25", "26", "27", "28", "29",
    "30", "31", "32", "33", "34", "35", "36"
]

# 出力先
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
DATASET_PATH = f"./image_classification/02_augmentation/{timestamp}"

# 分割比率
DATASET_RATIO = [0.8, 0.1, 0.1]
# クラス毎の最終サンプル数
TARGET_SAMPLES_PER_CLASS = 1000
# 画像サイズ
IMAGE_SIZE = 224
augmentation.py の全文を見る
import os
import random
from pathlib import Path
from PIL import Image
import torchvision.transforms as transforms

import train_utils.config as conf

TRAIN_NUM = int(conf.TARGET_SAMPLES_PER_CLASS * conf.DATASET_RATIO[0])
VAL_NUM = int(conf.TARGET_SAMPLES_PER_CLASS * conf.DATASET_RATIO[1])
TEST_NUM = conf.TARGET_SAMPLES_PER_CLASS - TRAIN_NUM - VAL_NUM

class RandomRotate180:
    def __call__(self, img):
        if random.random() < 0.5:
            return img.rotate(180)
        return img

augment_transform = transforms.Compose([
    transforms.Resize((conf.IMAGE_SIZE, conf.IMAGE_SIZE)),
    RandomRotate180(),
    transforms.RandomRotation(5),
    transforms.RandomAffine(
        degrees=0,
        translate=(0.03, 0.03),
        scale=(0.95, 1.05)
    ),
    transforms.ColorJitter(
        brightness=0.25,
        contrast=0.25,
        saturation=0.25,
        hue=0.02
    ),
])


# ======================================
# 元画像を分割
# ======================================
def split_original_images(files):
    random.shuffle(files)
    total = len(files)
    train_end = int(total * conf.DATASET_RATIO[0])
    val_end = train_end + int(total * conf.DATASET_RATIO[1])

    return (
        files[:train_end],
        files[train_end:val_end],
        files[val_end:]
    )


# ======================================
# splitデータ生成
# ======================================
def generate_split_dataset(miss, correct):
    def generate(t_samples, target_count):
        generated = []
        originals = []

        for img_path in t_samples:
            img = Image.open(str(img_path)).convert("RGB")

            img = img.resize((conf.IMAGE_SIZE, conf.IMAGE_SIZE))
            originals.append((f"{img_path.stem}_orig.jpg",img))

        generated.extend(originals)

        # --------------------------
        # 元画像が目標以上
        # --------------------------
        if len(generated) >= target_count:
            return random.sample(generated, target_count)

        # --------------------------
        # 不足分Aug
        # --------------------------
        need = target_count - len(generated)
        for i in range(need):
            img_path = random.choice(t_samples)
            img = Image.open(str(img_path)).convert("RGB")
            aug_img = augment_transform(img)
            generated.append((f"{img_path.stem}_aug_{i}.jpg", aug_img))

        return generated


    samples = miss + correct

    if len(samples) >= conf.TARGET_SAMPLES_PER_CLASS:
        if len(miss) >= conf.TARGET_SAMPLES_PER_CLASS:
            samples = random.sample(miss, conf.TARGET_SAMPLES_PER_CLASS)
        else:
            samples = miss + random.sample(correct, conf.TARGET_SAMPLES_PER_CLASS - len(miss))


    random.shuffle(samples)
    total = len(samples)
    train_end = int(total * conf.DATASET_RATIO[0])
    val_end = train_end + int(total * conf.DATASET_RATIO[1])

    train_samples = samples[:train_end]
    val_samples = samples[train_end:val_end]
    test_samples = samples[val_end:]

    train_samples = generate(train_samples, TRAIN_NUM)
    val_samples = generate(val_samples, VAL_NUM)
    test_samples = generate(test_samples, TEST_NUM)

    return train_samples, val_samples, test_samples


def augment():
    for cls_name in conf.CLASSES:
        ###### ディレクトリ作成
        for split in ["train", "val", "test"]:
            path = os.path.join(conf.DATASET_PATH, split, cls_name)
            os.makedirs(path, exist_ok=True)

        ###### データセット分割

        # 1. 対象サンプルを走査し、数を取得
        miss_img_paths = []
        correct_img_paths = []
        for target_dir in conf.TARGET_SAMPLE:
            target_dir = Path(target_dir)
            miss_class = target_dir / "miss" / cls_name
            correct_class = target_dir / "correct" / cls_name

            miss_img_paths.extend(sorted(miss_class.rglob("*.jpg")))
            correct_img_paths.extend(sorted(correct_class.rglob("*.jpg")))

        print(f"{cls_name}_count: [miss: {len(miss_img_paths)}, correct: {len(correct_img_paths)}]")

        # 2. miss, correctの数に応じて処理を行う
        train, val, test = generate_split_dataset(miss_img_paths, correct_img_paths)


        # 3. 保存
        save_split_data(train,"train",cls_name)
        save_split_data(val,"val",cls_name)
        save_split_data(test,"test",cls_name)


# ======================================
# 保存
# ======================================
def save_split_data(data,split_name,cls_name):
    output_dir = os.path.join(conf.DATASET_PATH, split_name, cls_name)
    for file_name, img in data:
        save_path = os.path.join(output_dir,file_name)
        img.save(save_path, quality=95)
ただし、この2ファイルを直接実行してデータセットを作るわけではありません。
config.pyは設定、augmentation.pyはデータセット生成処理をまとめた部品として使い、最終的には03_train_main.pyから呼び出します。
今回はその中でも、EfficientNetへ渡す学習画像をどのように用意しているのかに絞って見ていきます。
今回やること
今回の処理の流れはシンプルです。
牌画像を用意する
↓
正しいフォルダ構成に整理する
↓
train / val / test に分ける
↓
データ拡張で画像を増やす
↓
EfficientNet用データセットを完成させる分割自体は一般的な手順ですが、今回の記事で特に見ていきたいのはその後のデータ拡張です。
まず入力となるフォルダ構成を用意する
今回のコードでは、まず元になる牌画像が次のような構成で整理されていることを前提にしています。
image_classification
└── 01_data
    ├── 20260627_123025
    │   ├── correct
    │   │   ├── 0
    │   │   ├── 1
    │   │   ├── 2
    │   │   └── ...
    │   └── miss
    │       ├── 0
    │       ├── 1
    │       ├── 2
    │       └── ...
    │
    ├── 20260710_120118
    │   ├── correct
    │   └── miss
    │
└── ...ここでのポイントは、牌IDごとに画像が分かれていることです。
今回の麻雀CPUでは、赤5も別クラスとして扱っているため、牌は全部で37クラスあります。
つまり、各フォルダの中には
0 ~ 36までのクラスフォルダが並びます。
correctには正しく認識できた画像、missには誤認識だった画像が入っています。
このcorrectやmissをどう作るのかはシリーズ最後の再学習編で詳しく扱う予定です。
今回は、すでに牌IDごとに画像が各フォルダに整理されている前提で始めます。
config.pyで設定する内容
データセット作成に必要な設定はconfig.pyにまとめています。
例えば今回重要なのは次のような項目です。
CLASSES = [
    "0", "1", "2", "3", "4", "5", "6", "7", "8", "9",
    "10", "11", "12", "13", "14", "15", "16", "17", "18", "19",
    "20", "21", "22", "23", "24", "25", "26", "27", "28", "29",
    "30", "31", "32", "33", "34", "35", "36"
]

DATASET_RATIO = [0.8, 0.1, 0.1]
TARGET_SAMPLES_PER_CLASS = 1000
IMAGE_SIZE = 224
意味としては次の通りです。
CLASSES
→ 学習対象のクラス一覧。今回は0〜36の37クラスです。DATASET_RATIO
→ train / val / test の分割比率です。今回は 8 : 1 : 1 にしています。TARGET_SAMPLES_PER_CLASS
→ 1クラスあたり最終的に何枚まで増やすかです。今回は1000枚です。IMAGE_SIZE
→ 画像サイズです。EfficientNet-B0に合わせて224にしています。
また、どの元データを使うかもここで指定しています。
TARGET_SAMPLE = [
    "./image_classification/01_data/20260627_123025",
    "./image_classification/01_data/20260710_120118",
    "./image_classification/01_data/20260714_214916",
    "./image_classification/01_data/20260722_194307",
]
複数回集めた牌画像をまとめて使う形です。
出力後のフォルダ構成
データセット作成が終わると、出力は次のような構成になります。
image_classification
└── 02_augmentation
    └── 2026xxxx_xxxxxx
        ├── train
        │   ├── 0
        │   ├── 1
        │   ├── 2
        │   └── ...
        ├── val
        │   ├── 0
        │   ├── 1
        │   ├── 2
        │   └── ...
        └── test
            ├── 0
            ├── 1
            ├── 2
            └── ...
つまり最終的には、
train/牌ID/画像val/牌ID/画像test/牌ID/画像
という、PyTorchで扱いやすい構成になります。
これで次回以降のdataset.pyから、そのまま読み込める状態になります。
データ分割は最小限で考える
今回、画像は
train 80%
val 10%
test 10%
に分けています。
ここは一般的な考え方です。
trainは学習に使うvalは学習途中の確認に使うtestは最後の評価に使う
という役割です。
この部分は特別な工夫というより、画像分類の基本的な準備です。
今回の記事で本当に大事なのは、このあとに行うデータ拡張です。
データ拡張で画像を増やす
37クラスすべてについて、最初から十分な枚数の画像を集めるのは大変です。
そこで今回のコードでは、足りない画像をデータ拡張で増やします。
使っている処理は次の通りです。
augment_transform = transforms.Compose([
    transforms.Resize((conf.IMAGE_SIZE, conf.IMAGE_SIZE)),
    RandomRotate180(),
    transforms.RandomRotation(5),
    transforms.RandomAffine(
        degrees=0,
        translate=(0.03, 0.03),
        scale=(0.95, 1.05)
    ),
    transforms.ColorJitter(
        brightness=0.25,
        contrast=0.25,
        saturation=0.25,
        hue=0.02
    ),
])
これを見ると、今回のデータ拡張は大きく分けて次の4種類です。
1. 180度回転
2. 小さな回転
3. 位置ずれ・拡大縮小
4. 明るさや色味の変化
180度回転を入れる理由
まず特徴的なのが、180度回転です。
class RandomRotate180:
    def __call__(self, img):
        if random.random() < 0.5:
            return img.rotate(180)
        return img
50%の確率で画像を180度回転しています。
麻雀牌は、卓上で見たときに上下が逆向きになることがあります。
特に自動認識では、カメラ位置や牌の向きによって見え方が変わります。
そのため、上下が逆の状態でも同じ牌として認識できるようにするために、この拡張を入れています。
小さな回転だけでは、この「ひっくり返った向き」は十分にカバーできません。
今回のような麻雀牌画像では、180度回転を個別に入れる意味があります。
小さな回転を入れる理由
次に、
transforms.RandomRotation(5)で、±5度の小さな回転を加えています。
実際にカメラで撮影すると、牌が完全にまっすぐ写るとは限りません。
少しだけ傾いていることの方が自然です。
そこで、わざと少し傾けた画像も学習に入れることで、実運用の微妙なズレに強くする狙いがあります。
ここで大きく回しすぎていないのもポイントです。
現実の卓上画像とかけ離れた角度まで回してしまうと、かえって不自然な学習データになります。
今回は、実際にありそうな範囲に抑えています。
位置ずれと拡大縮小を入れる理由
次に、Affine変換で位置ずれと拡大縮小を加えています。
transforms.RandomAffine(
    degrees=0,
    translate=(0.03, 0.03),
    scale=(0.95, 1.05)
)
ここで行っているのは、
- 上下左右に少しずらす
- 少しだけ拡大・縮小する
という変化です。
YOLOで牌を切り出しても、毎回まったく同じ位置・同じ大きさで切り出せるわけではありません。
少し中央からずれたり、牌が少し大きめ・小さめに入ったりします。
そこで、学習時にもそのズレを再現しておきます。
これによって、切り出し位置のブレに対しても分類が安定しやすくなります。
明るさや色味を変える理由
さらに、ColorJitterで見た目の明るさや色味も変えています。
transforms.ColorJitter(
    brightness=0.25,
    contrast=0.25,
    saturation=0.25,
    hue=0.02
)
ここで変えているのは、
- 明るさ
- コントラスト
- 彩度
- 色相
です。
麻雀卓の上では、
- 照明が明るい日
- 少し暗い日
- カメラの露出が違うとき
- 牌の白さや影の出方が違うとき
など、見え方が少しずつ変わります。
元画像がきれいに撮れていても、運用時にはまったく同じ条件にはなりません。
そのため、画像の見た目を少し変化させたものも学習させて、照明や色味の違いに強くすることを狙っています。
なぜデータ拡張が重要なのか
今回の麻雀牌画像では、種類ごとの模様の違いはもちろん重要です。
ただ実際には、それと同じくらい
- 角度
- 向き
- 切り出し位置
- 明るさ
の影響を受けます。
つまり、モデルにとって難しいのは
**「牌の種類を覚えること」だけではなく、「見え方が少し変わっても同じ牌と判断すること」**です。
そのため今回のデータ拡張は、単に枚数を増やすためだけではありません。
実際に使うときに起きる見え方の揺らぎを、あらかじめ学習させる
という役割があります。
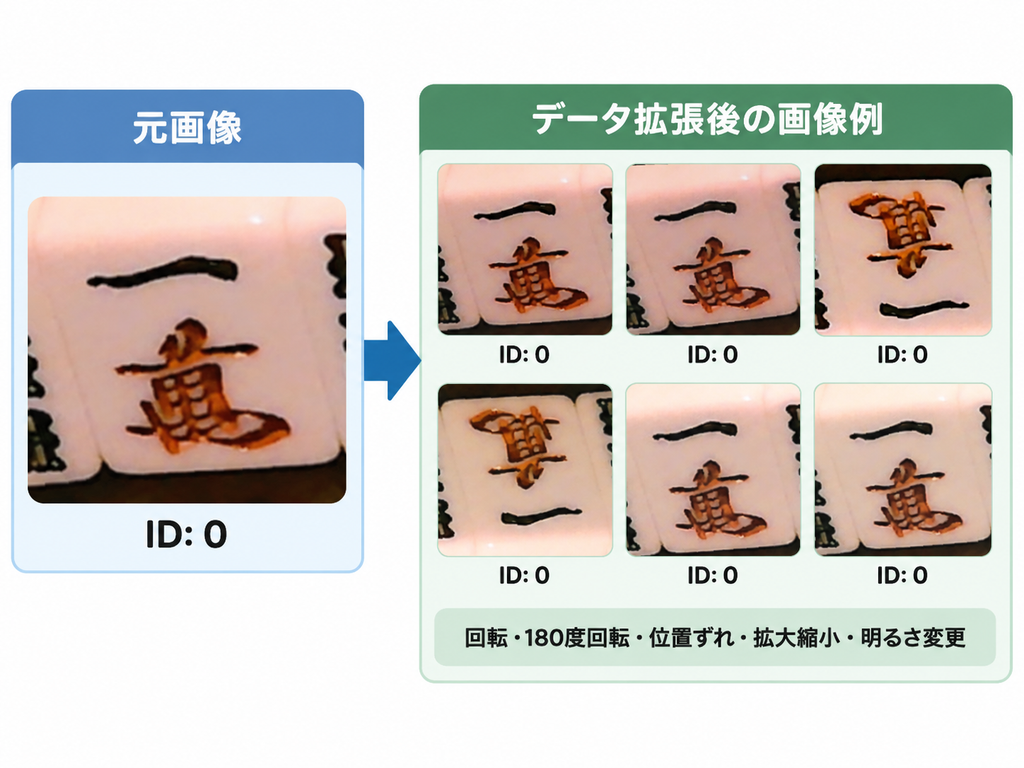
例えば一萬の元画像からは、次のような画像が生成されます。
分割してからデータ拡張する
今回のコードでは、元画像を先に
train / val / testに分けてから、それぞれの中でデータ拡張をしています。
これはかなり大事です。
もし先に拡張画像を大量に作ってから分割すると、同じ元画像から作ったよく似た画像が、trainとtestの両方に入ってしまう可能性があります。
それでは、テストが甘くなってしまいます。
そのため順番は、
元画像を分割
↓
各splitでデータ拡張
にしています。
実際の推論結果を使って学習データを増やす
今回の学習データは、最初から大量に用意したものだけを使っているわけではありません。
まずは比較的少量の牌画像を使ってEfficientNetを学習し、そのモデルを実際の麻雀CPUに搭載します。
そして、麻雀CPUを動かして推論したときの牌画像を保存しておきます。
流れとしては、
少量の画像で最初のモデルを学習
↓
麻雀CPUにモデルを搭載
↓
実際に牌を推論
↓
推論した牌画像を保存
↓
あとから人間が結果を確認
↓
correct / miss に仕分け
↓
再学習
という形です。
ここでのcorrectとmissの仕分けは自動ではなく、人間が実際の画像を見ながら行っています。
例えばAIが五筒と判定した画像を見て、
本当に五筒ならcorrect、
実際には六筒だったなら、正しい牌を指定してmiss
として保存します。
この仕分けを行うためのアプリも作っていて、シリーズ後半の再学習編で紹介する予定です。
missを多めに使い、correctは補強として使う
再学習では、correctとmissを同じ割合で使っているわけではありません。
特に重視しているのがmissの画像です。
missには、
実際の麻雀CPUで推論した結果、モデルが間違えた画像
が入っています。
つまり、
今のモデルが苦手だった画像を集めたデータとも言えます。
そこで今回のデータセット作成では、missをできるだけ多く使い、不足する分をcorrectで補うようにしています。
イメージとしては、
miss
→ 苦手なパターンを重点的に学習

correct
→ 全体の認識を崩さないための補強
という役割です。
correctを使わないわけではありません。
正しく認識できている画像も残しつつ、間違えた画像をより多めに次の学習へ戻すようにしています。
こうすることで、
最初のモデルを作る
↓
実際に使う
↓
間違えた画像を集める
↓
苦手な画像を多めに再学習
↓
もう一度使う
という改善サイクルを回しています。
今回のaugmentation.pyは、その再学習に使う画像を集め、必要な枚数までデータ拡張して整える役割も持っています。
correctとmissを実際に人力で仕分けるアプリについては、シリーズ最後の**「誤認識した麻雀牌画像を教師データにする|実際の認識結果から再学習する」**で詳しく紹介します。
まとめ
今回は、EfficientNet-B0を学習するためのデータセット作りを紹介しました。
流れとしては、
牌画像を用意する
↓
correct / miss / 牌IDごとに整理する
↓
train / val / test に分ける
↓
データ拡張で画像を増やす
↓
02_augmentation に出力する
となります。
特に重要なのは、今回のデータ拡張で
- 180度回転
- 小さな回転
- 位置ずれ
- 拡大縮小
- 明るさや色味の変化
を加えていることです。
こうすることで、実際の麻雀卓で起こる向き・位置・照明の違いに対応しやすくしています。
次回は、このデータセットをPyTorchから読み込むためのdataset.pyを作ります。
ただ37クラスをそのまま扱うだけではなく、
Stage1
萬子 / 筒子 / 索子 / 字牌

Stage2
各グループ内の具体的な牌という二段階分類用のDatasetにしていきます。
コメント