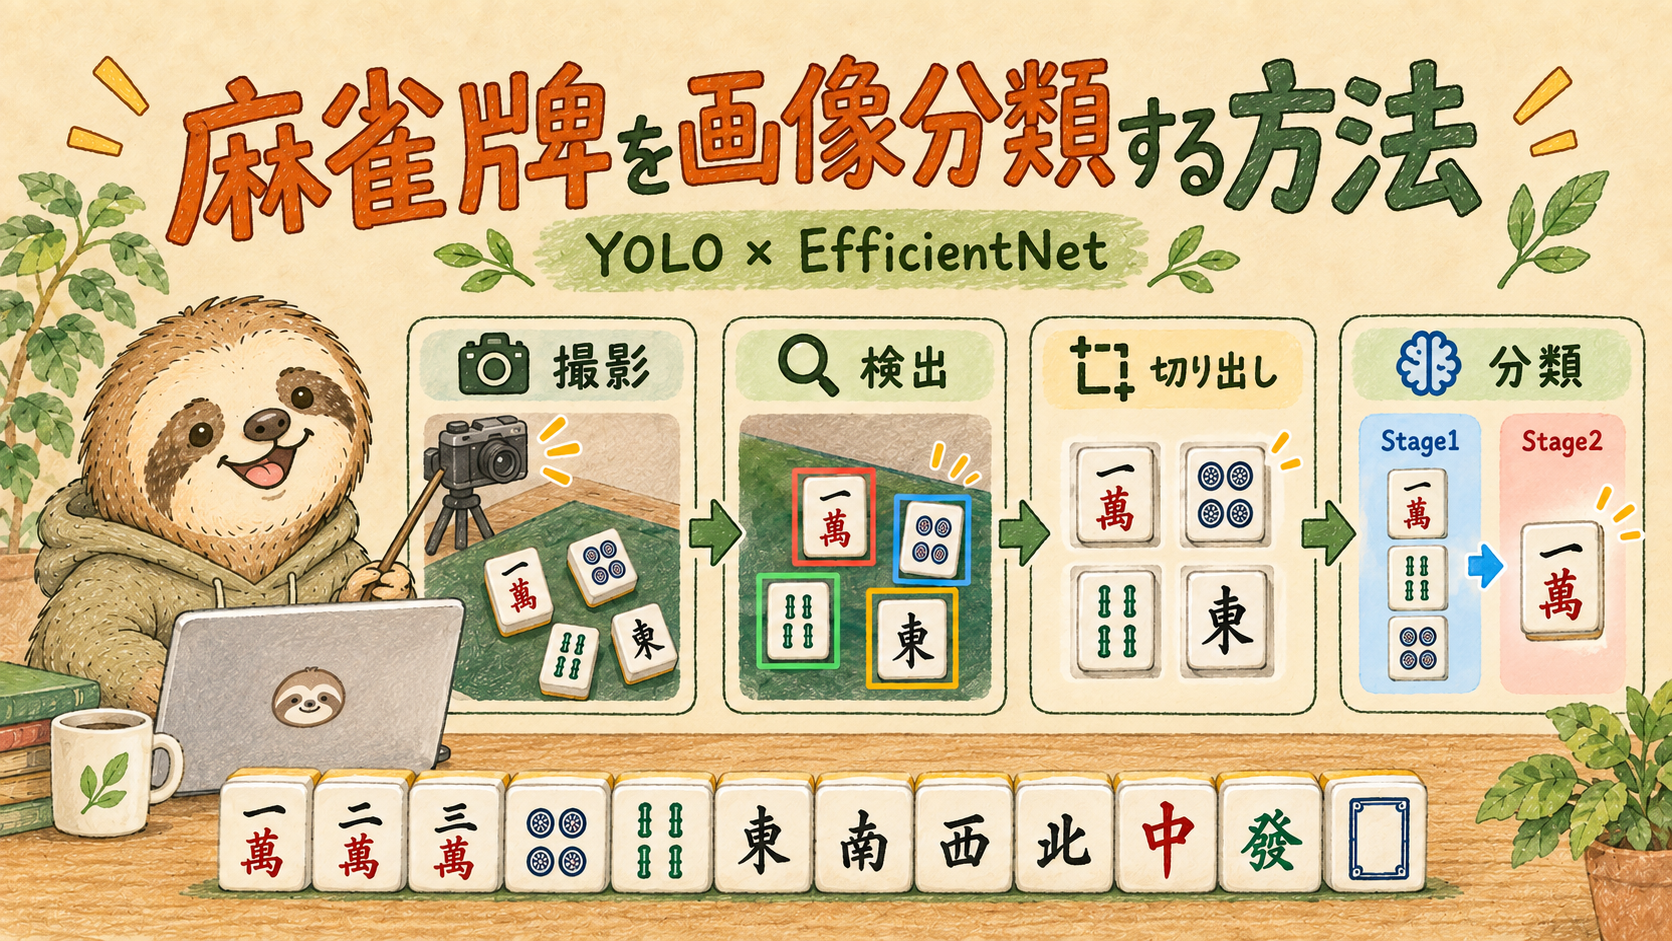
前回までのYOLO編では、カメラ画像から麻雀牌を検出するモデルを作ってきました。
今回からは、検出した牌が
「一萬なのか」
「五筒なのか」
「東なのか」
といった牌の種類を判定する画像分類を作っていきます。
画像分類にはEfficientNet-B0を使用します。
ここで最初に書いておきたいのが、
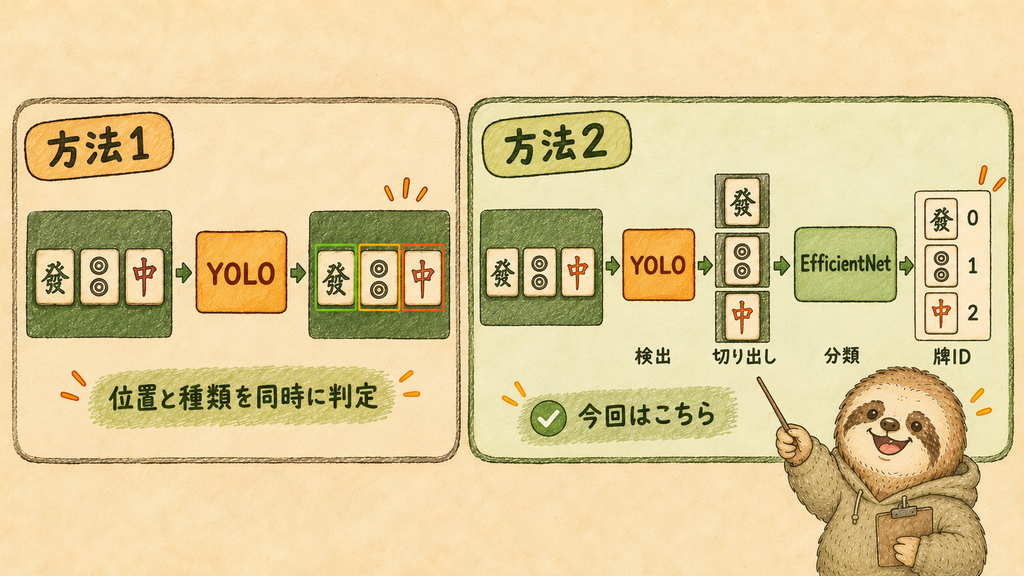
YOLOでも牌の位置と種類を同時に判定できる
ということです。
今回はYOLOで種類を判定できなかったからEfficientNetを追加したわけではありません。
あえて、
YOLOは牌の位置を検出する
EfficientNetは牌の種類を分類する
という役割分担にしています。
今回は、その構成にした理由と画像分類全体の流れを紹介します。
YOLOだけでも牌の種類は判定できる
YOLOは物体がある場所を見つけるだけのモデルではありません。
例えば37種類の麻雀牌をそれぞれクラスとして学習させれば、
この位置に五筒がある
この位置に東がある
この位置に赤五萬があるというように、位置と牌の種類を一度に取得することもできます。
つまり、
カメラ画像
↓
YOLO
↓
位置+牌種類
という構成でも麻雀牌認識は作れます。
それでも今回の麻雀CPUでは、この方法にはしませんでした。
YOLOには牌がどこにあるのかだけを検出してもらい、牌の種類については別の画像分類モデルに任せています。
あえて検出と分類を分ける
現在の構成は次のようになっています。
カメラ画像
↓
YOLO
麻雀牌の位置を検出
↓
牌画像を1枚ずつ切り出す
↓
EfficientNet
牌の種類を分類
↓
牌IDを決定
YOLO側では、
「これは麻雀牌である」
というところまで担当します。
その牌が何なのかは、切り出した画像をEfficientNetに渡して判定します。
こうすることで、
物体を見つける処理
と
牌の模様を見分ける処理
を別々に改善できます。
例えば実際に使っていて「筒子の認識だけ間違えやすい」と分かった場合でも、YOLOを作り直す必要はありません。
画像分類側に学習データを追加して、EfficientNetだけを再学習できます。
実際の麻雀CPUを使いながら認識ミスを集め、少しずつ改善していく今回の使い方では、この構成の方が管理しやすいと考えました。
37種類をさらに二段階で分類する
今回の麻雀CPUでは、赤5も通常の5とは別の牌として扱っています。
そのため分類する牌は、
- 萬子:1〜9+赤5
- 筒子:1〜9+赤5
- 索子:1〜9+赤5
- 字牌:7種類
の合計37種類です。
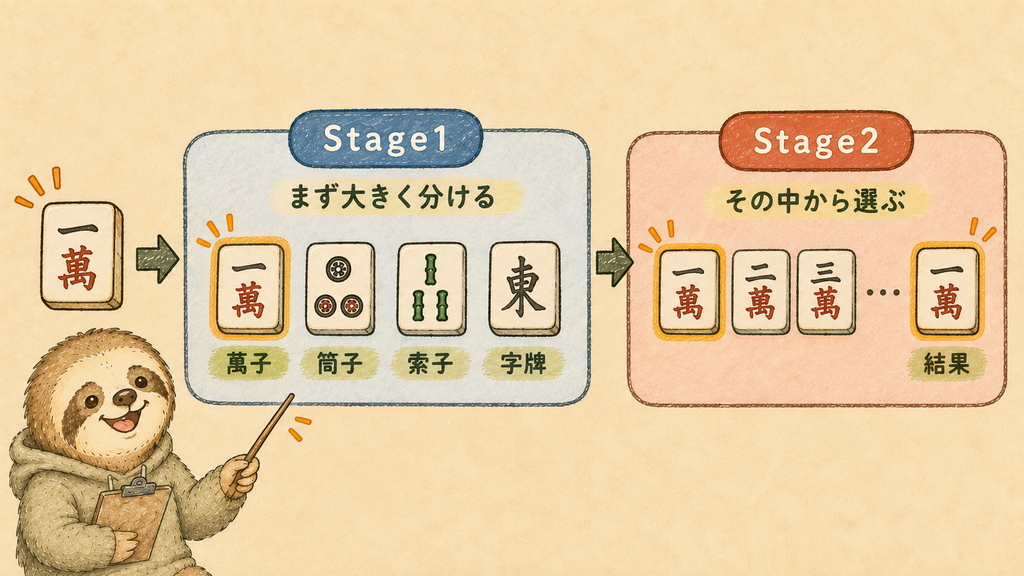
EfficientNetで37種類を一度に分類することもできますが、ここでもさらに処理を分けています。
まずStage1で、
萬子
筒子
索子
字牌
の4種類に分類します。
例えば五筒なら、
五筒の画像
↓
Stage1
↓
筒子
となります。
次にStage2で、そのグループの中から具体的な牌を判定します。
筒子
↓
筒子用モデル
↓
五筒
つまり、
大分類 → 詳細分類
という二段階です。
なぜ37種類を一度に分類しないのか
麻雀牌には、萬子・筒子・索子・字牌それぞれに共通した特徴があります。
そこで最初から37種類すべてを候補にするのではなく、
まず4グループに絞る
↓
そのグループの中から判定する
という構成にしました。
Stage2のモデルも、
- 萬子用
- 筒子用
- 索子用
- 字牌用
に分かれています。
そのため、特定の種類だけ認識精度に問題があったときにも、どこを改善すればよいか分かりやすくなります。
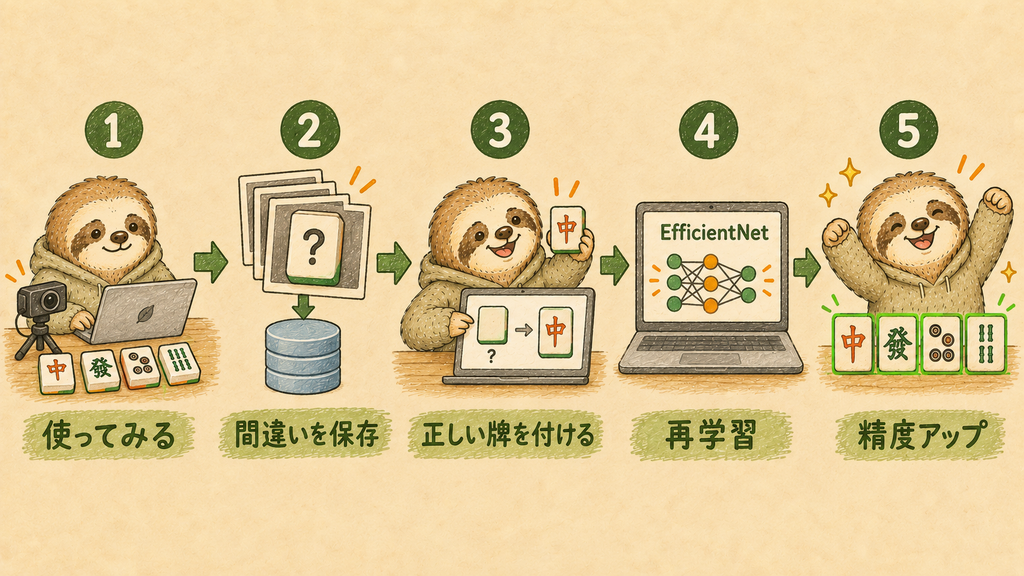
認識ミスを集めて再学習する
画像分類モデルは、一度作って終わりではありません。
麻雀CPUを実際に使っていて認識を間違えた場合、その牌画像を保存します。
その後、人間が正しい牌を指定して再学習用のデータとして使用します。
麻雀CPUを使う
↓
認識ミスを保存
↓
正しい牌を設定
↓
EfficientNetを再学習
↓
認識精度を改善
実際に間違えた画像は、現在のモデルが苦手としている画像でもあります。
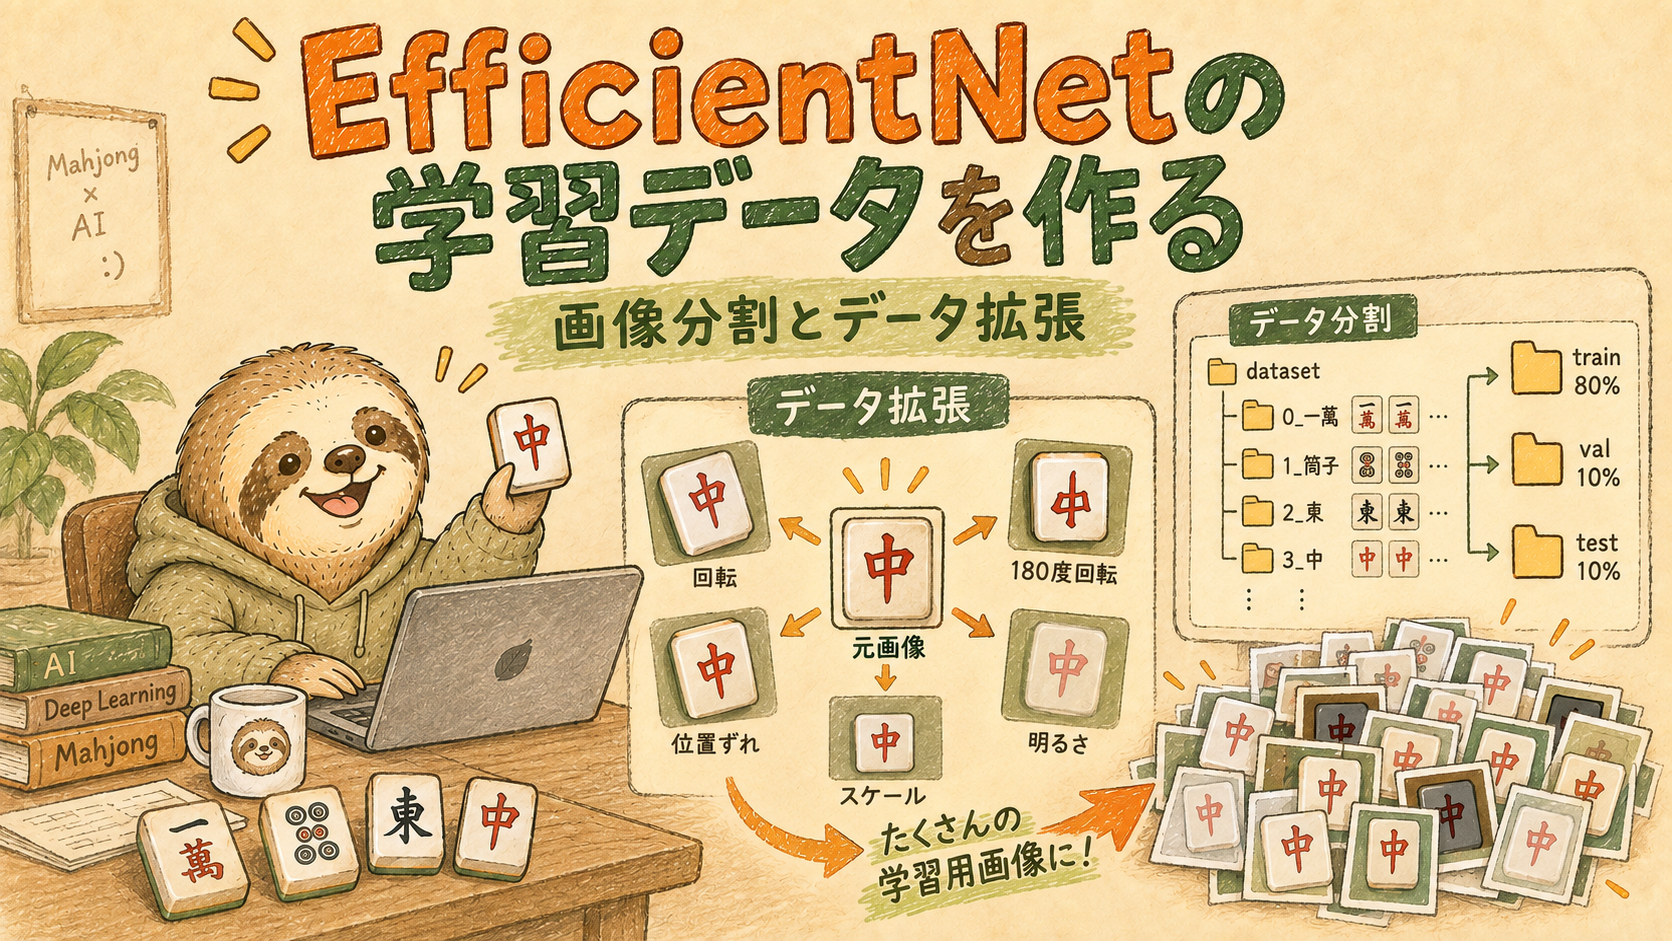
今回の画像分類編では、この学習データを作るところから順番に紹介していきます。
まとめ
今回のポイントは、
YOLOでは牌の種類を判定できないからEfficientNetを使うわけではない
ということです。
YOLOでも、
「どこに」「何の牌があるか」
を同時に判定できます。
それでも今回は、
YOLO
牌の位置を検出
↓
EfficientNet Stage1
萬子 / 筒子 / 索子 / 字牌
↓
EfficientNet Stage2
具体的な牌を分類
と役割を分けました。
検出と分類を独立させることで、実際に麻雀CPUを使いながら画像分類部分だけを再学習しやすくしています。
次回は、実際に麻雀CPUから保存した牌画像を確認し、
正しく認識できた画像と誤認識した画像を学習データとして整理する方法
を紹介します。
コメント