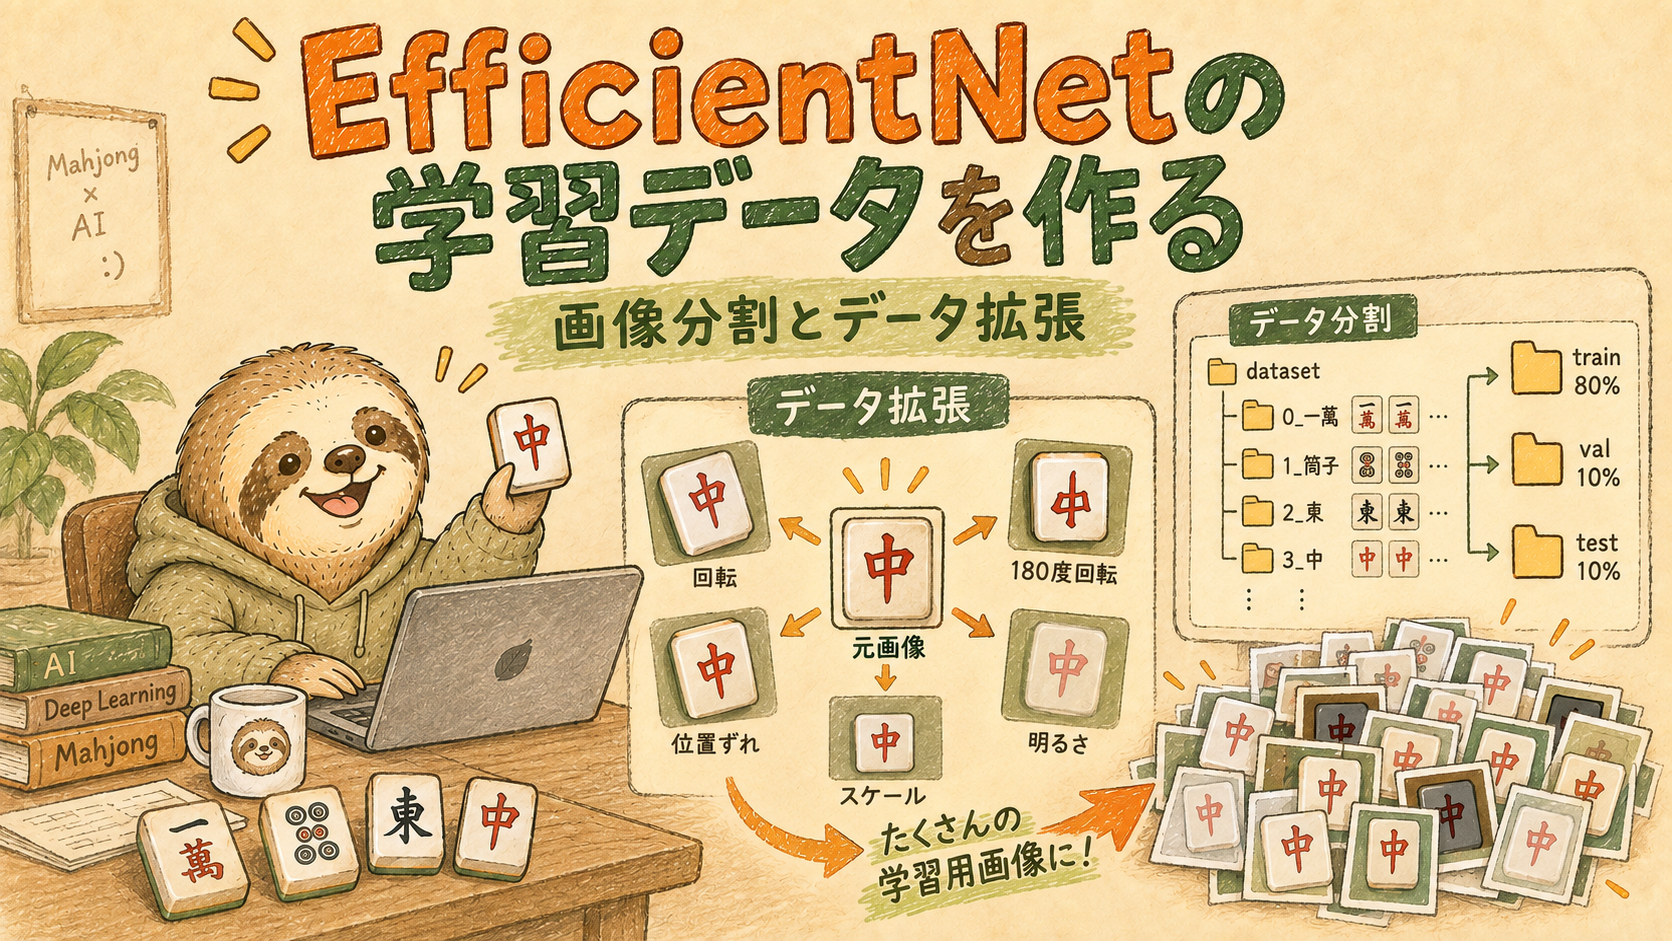
前回は、EfficientNetで学習するための牌画像を用意し、回転・位置ずれ・明るさ変更などのデータ拡張を行いました。
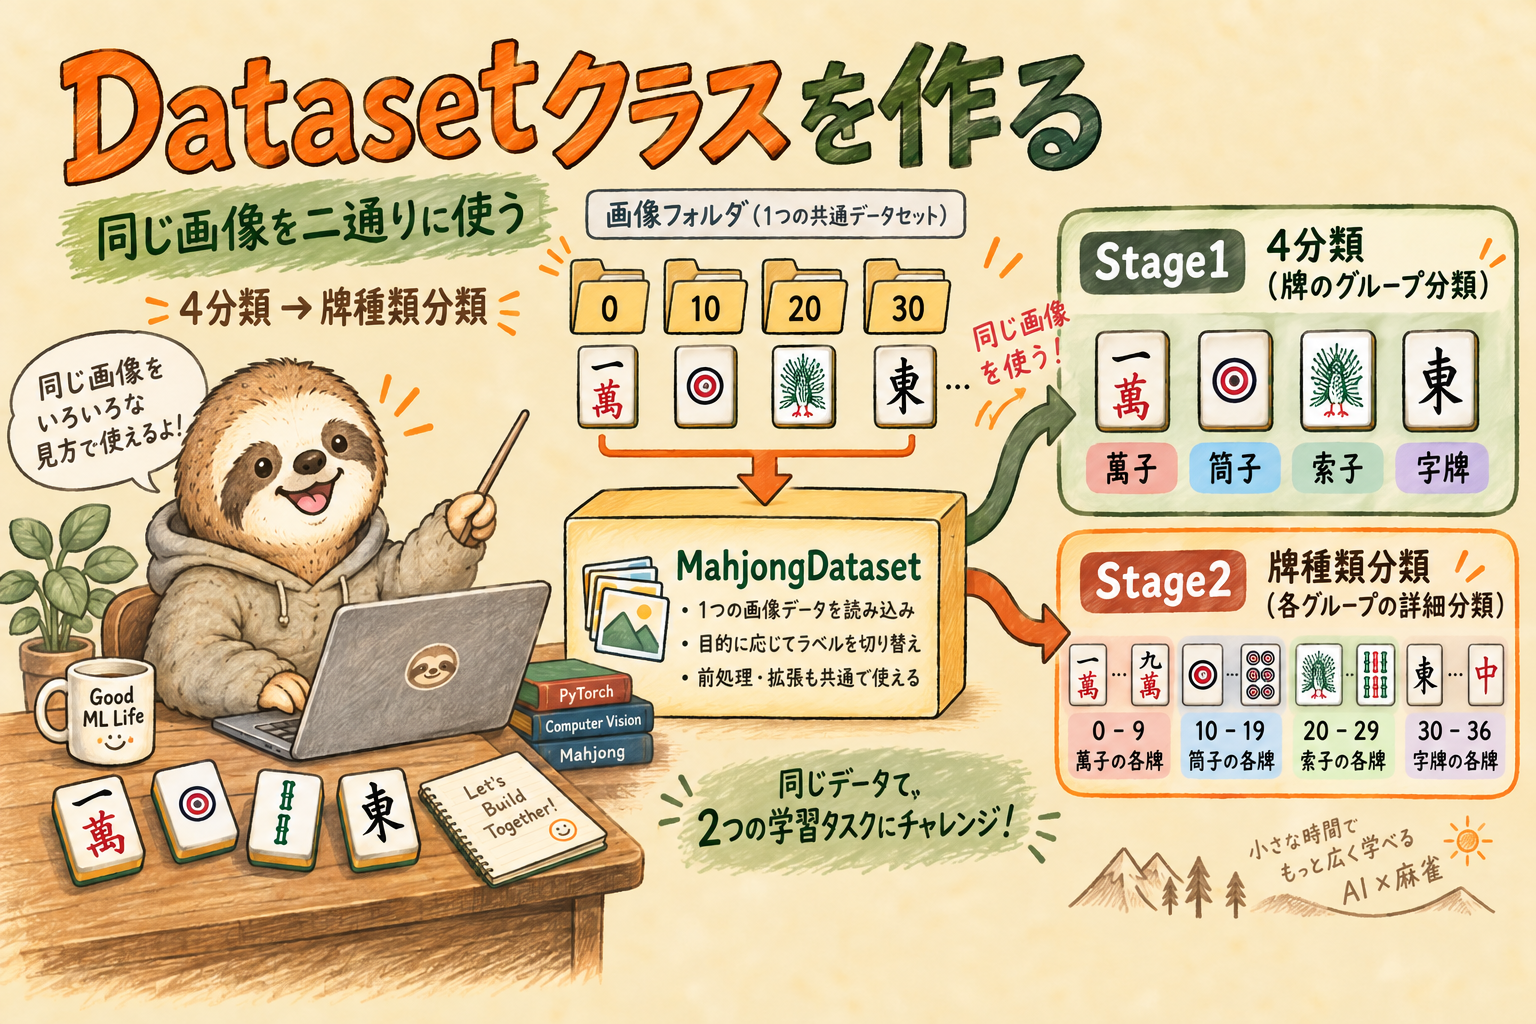
今回は、その画像をPyTorchから読み込むためのDataset クラスを作ります。
今回のポイントは、単に画像ファイルを読み込むことではありません。
麻雀牌37種類の画像を二段階で分類するため
Stage1
萬子 / 筒子 / 索子 / 字牌

Stage2
各グループ内の具体的な牌という二通りの学習データとして使う必要があります。
そこで今回は、画像を読み込む処理を関数としてバラバラに作るのではなく、MahjongDatasetというクラスにまとめました。
なぜDatasetをクラスにしたのか、その理由を中心に見ていきます。
今回使用するコードは次のファイルです。
dataset.py の全文を見る
from PIL import Image
from pathlib import Path
from torch.utils.data import Dataset


class MahjongDataset(Dataset):
    GROUPS = {
        "manzu": list(range(0, 10)),
        "pinzu": list(range(10, 20)),
        "souzu": list(range(20, 30)),
        "jihai": list(range(30, 37)),
    }

    CLASS4_NAMES = [
        "manzu",
        "pinzu",
        "souzu",
        "jihai",
    ]

    def __init__(
        self,
        root_dir,
        split="train",
        task="class4",
        group=None,
        transform=None,
    ):
        """
        Parameters
        ----------
        root_dir
            datasetのルート
        split
            train / val / test
        task
            class4 または stage2
        group
            stage2時のみ
            manzu / pinzu / souzu / jihai
        """

        self.transform = transform
        self.samples = []

        root_dir = Path(root_dir) / split

        if not root_dir.exists():
            raise FileNotFoundError(root_dir)

        # -----------------------------
        # class4
        # -----------------------------
        if task == "class4":
            self.class_names = self.CLASS4_NAMES
            for class_index, group_name in enumerate(self.CLASS4_NAMES):
                tile_ids = self.GROUPS[group_name]
                for tile_id in tile_ids:
                    image_dir = root_dir / str(tile_id)
                    if not image_dir.exists():
                        continue
                    for image_path in image_dir.iterdir():
                        if image_path.suffix.lower() not in (".jpg"):
                            continue

                        self.samples.append((image_path, class_index,))

        # -----------------------------
        # stage2
        # -----------------------------
        elif task == "stage2":
            if group is None:
                raise ValueError("group must be specified.")

            if group not in self.GROUPS:
                raise ValueError(group)

            tile_ids = self.GROUPS[group]
            # モデルから返したいクラス名
            self.class_names = [str(i) for i in tile_ids]

            label_map = {
                tile_id: index
                for index, tile_id
                in enumerate(tile_ids)
            }

            for tile_id in tile_ids:
                image_dir = root_dir / str(tile_id)
                if not image_dir.exists():
                    continue
                for image_path in image_dir.iterdir():
                    if image_path.suffix.lower() not in (".jpg"):
                        continue

                    self.samples.append((image_path, label_map[tile_id],))

        else:
            raise ValueError(task)

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, index):
        image_path, label = self.samples[index]
        image = Image.open(image_path).convert("RGB")
        if self.transform is not None:
            image = self.transform(image)
return image, labelなお、dataset.pyは単体で実行するファイルではありません。
ここでは画像とラベルを読み込むためのMahjongDatasetを作り、後の記事で紹介するtrain_main.pyから呼び出して使用します。
なぜDatasetをクラスにするのか
今回のDatasetでは、画像を1枚読み込むだけではなく、
どのフォルダを使うか
train / val / testのどれか
Stage1かStage2か
Stage2ならどのグループか
なにに分類するのか
画像にどんな前処理をするか
どの画像とラベルを使うか
といった情報をまとめて管理する必要があります。
これらを毎回関数の引数として渡しながら処理することもできます。
ただ、学習中は何度も画像を取り出すため、そのたびに条件を判定するより、
最初に「このDatasetは何をするものか」を決めて、その状態を持たせておく
方が扱いやすくなります。
そこで、
class MahjongDataset(Dataset):としてクラスにしました。
例えば、
dataset = MahjongDataset(
    root_dir=dataset_path,
    split="train",
    task="class4",
)
と作った時点で、
「train画像を使うStage1用Dataset」
という1つのオブジェクトになります。
一方、
dataset = MahjongDataset(
    root_dir=dataset_path,
    split="train",
    task="stage2",
    group="pinzu",
)
なら、
「train画像を使う筒子のStage2用Dataset」
になります。
同じクラスでも、作るときの条件によって役割を変えられるようにしています。
PyTorchのDatasetとして使えるようにする
もう一つ大きな理由が、PyTorchのDatasetと組み合わせるためです。
from torch.utils.data import Dataset

class MahjongDataset(Dataset):
と継承し、
def __len__(self):と、
def __getitem__(self, index):を用意します。
__len__では、Datasetに何枚の画像があるのかを返します。
def __len__(self):
return len(self.samples)__getitem__では、指定された番号の画像とラベルを返します。
def __getitem__(self, index):
    image_path, label = self.samples[index]

    image = Image.open(
        image_path
    ).convert("RGB")

    if self.transform is not None:
        image = self.transform(image)

return image, labelこれによって、後でPyTorchのDataLoaderへそのまま渡せる形になります。
つまりMahjongDatasetは、
画像フォルダとPyTorchの学習処理をつなぐ役割
を持っています。
画像そのものではなく「画像パスとラベル」を持たせる
Datasetを作るときに、すべての画像を最初からメモリへ読み込んでいるわけではありません。
クラス内部のself.samplesには、
画像ファイルのパス
+
学習用ラベル
を保存します。
イメージとしては、
self.samples

画像Aのパス → ラベル0
画像Bのパス → ラベル0
画像Cのパス → ラベル1
画像Dのパス → ラベル2
...
という状態です。
実際に学習で画像が必要になったときに、__getitem__で画像ファイルを開きます。
この形にしておくことで、Datasetクラスは、
どの画像を、何として学習するのか
だけを管理できます。
同じクラスでStage1とStage2を切り替える
今回クラスにした一番大きなメリットが、Stage1とStage2を同じDatasetで扱えることです。
牌IDは次の4グループに分けています。
GROUPS = {
    "manzu": list(range(0, 10)),
    "pinzu": list(range(10, 20)),
    "souzu": list(range(20, 30)),
    "jihai": list(range(30, 37)),
}
つまり、
0〜9   → 萬子
10〜19 → 筒子
20〜29 → 索子
30〜36 → 字牌
です。
Datasetを作るときに、
task="class4"を指定すればStage1として動きます。
一方、
task="stage2"
group="pinzu"
とすればStage2の筒子用Datasetになります。
これを別々の関数で作るのではなく、
MahjongDatasetという1つのクラスの中で切り替える
構成にしています。
Stage1では37種類を4種類に読み替える
Stage1では、元画像の牌IDをそのままラベルにはしません。
例えば、
ID 0
ID 1
ID 2
...
ID 9
はすべて萬子なので、
ラベル0 → manzuとして扱います。
同様に、
0〜9   → manzu
10〜19 → pinzu
20〜29 → souzu
30〜36 → jihai
の4クラスにまとめます。
元の画像フォルダは、
train
├── 0
├── 1
├── 2
├── ...
└── 36
のままです。
Datasetクラスの中で、
37種類のフォルダ
↓
4種類の学習ラベル
へ変換しています。
Stage2では必要なグループだけ使う
Stage2では逆に、必要なグループの画像だけを読み込みます。
例えば、
group="pinzu"なら、
10〜19の画像だけをDatasetへ登録します。
そのため同じMahjongDatasetから、
manzu用Dataset
pinzu用Dataset
souzu用Dataset
jihai用Dataset
を作ることができます。
もしこれをクラスにせず個別に作っていたら、
4分類を作る処理
萬子を作る処理
筒子を作る処理
索子を作る処理
字牌を作る処理
をそれぞれ管理することになります。
クラスにまとめることで、画像を集める基本処理は共通化し、違う部分だけ設定で切り替えられるようになりました。
Stage2では学習用ラベルを振り直す
Stage2では、元の牌IDとEfficientNetの出力番号がそのまま一致するとは限りません。
例えば筒子なら元の牌IDは、
10
11
12
...
19
です。
しかし筒子モデルから見れば10クラスしかないため、
0
1
2
...
9
として学習させます。
そこで、
label_map = {
    tile_id: index
    for index, tile_id
    in enumerate(tile_ids)
}
として、
牌ID 10 → ラベル0
牌ID 11 → ラベル1
牌ID 12 → ラベル2
...
牌ID 19 → ラベル9
に変換します。
一方、元の牌IDは、
self.class_names = [
    str(i) for i in tile_ids
]
としてDataset側に残しています。
これもクラスにしているメリットです。
画像だけでなく、
このDatasetで使っているクラス情報も一緒に持たせる
ことができます。
クラスにしたことで役割がはっきりした
今回のMahjongDatasetをまとめると、このクラスが持っているのは、
root_dir
どこの画像を使うか

split
train / val / test

task
Stage1 / Stage2

group
萬子 / 筒子 / 索子 / 字牌

samples
画像パスとラベル

class_names
そのDatasetが扱うクラス

transform
画像の前処理
です。
つまり、
「この学習で使う画像データ一式の情報」
を1つのオブジェクトとして持っています。
そのため学習側では、
train_dataset = MahjongDataset(...)と作ったあと、
Datasetの内部がどういうフォルダを探しているのかを毎回意識する必要がありません。
学習処理は、出来上がったDatasetを受け取って使うだけになります。
これは後でtrainer.pyと役割を分けるうえでも重要です。
同じ画像データを増やさず使い回せる
前回作った画像は、
train / 0〜36
val   / 0〜36
test  / 0〜36
の1セットだけです。
Stage1用、Stage2用に画像をコピーしてはいません。
代わりに、
同じ画像データ
        ↓
MahjongDataset
        ↓
taskとgroupで読み方を変更
しています。
task="class4"
↓
4分類Dataset

task="stage2"
group="manzu"
↓
萬子Dataset

task="stage2"
group="pinzu"
↓
筒子Dataset
となります。
この構成なら、後から学習画像を増やした場合も、元の0〜36のフォルダだけ更新すれば済みます。
二段階分類だからといって、データそのものまで二重に管理する必要はありません。
画像分類AIを作る時データが増えてしまいSSDの容量を圧迫してしまいます。
このようにしていればSSDにも人にも優しい設計になります。
まとめ
今回は、二段階分類で使うMahjongDatasetを作りました。
今回Datasetをクラスにした理由は、単にPyTorchの書き方に合わせるためだけではありません。
どの画像を使うのか
どんな分類をするのか
どのグループを対象にするのか
画像とラベルの対応
クラス情報
画像の前処理を、1つのDatasetとしてまとめて管理するためです。
特に今回のように、
Stage1
37種類 → 4分類

Stage2
グループ内 → 詳細分類
と同じ画像を二通りに使う場合、Datasetをクラスにして設定だけ切り替える構成が扱いやすくなります。
また、
画像を管理する
↓
MahjongDataset

モデルを学習する
↓
trainer.py
と役割を分けることもできます。
次回は、このMahjongDatasetを受け取って実際に学習を行う、
trainer.py
を作ります。
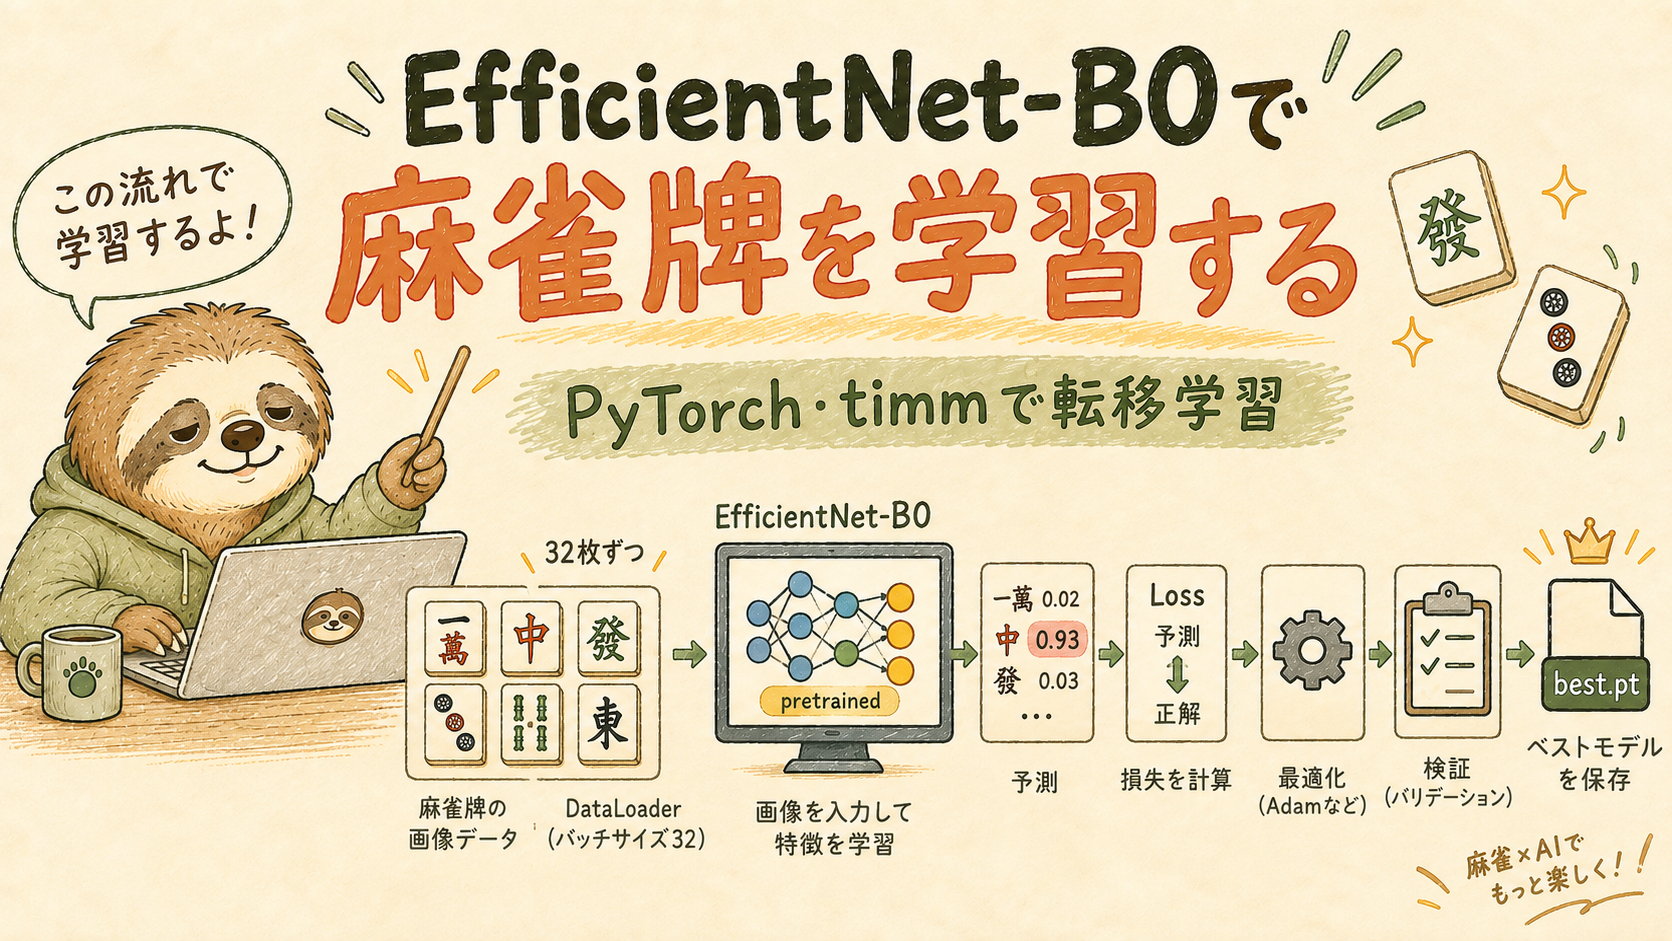
EfficientNet-B0の読み込み、DataLoader、損失関数、Optimizerなどをまとめて、学習処理をクラスとして作っていきます。
コメント