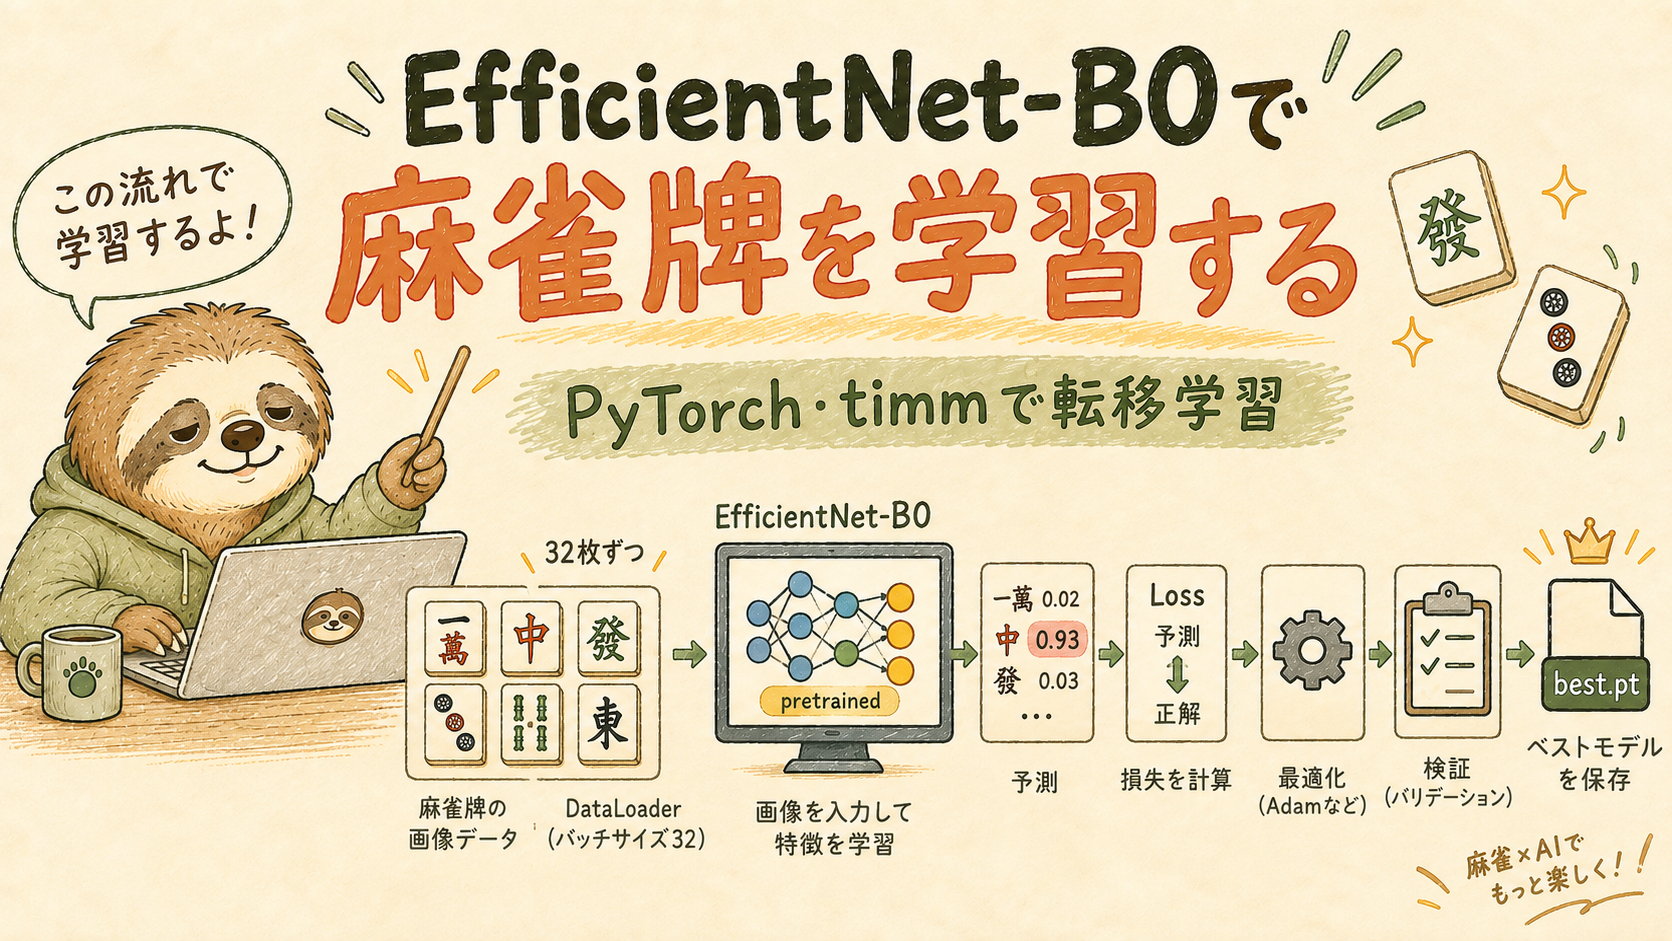
前回は、ImageClassifierTrainerを作り、EfficientNet-B0を学習する処理を実装しました。
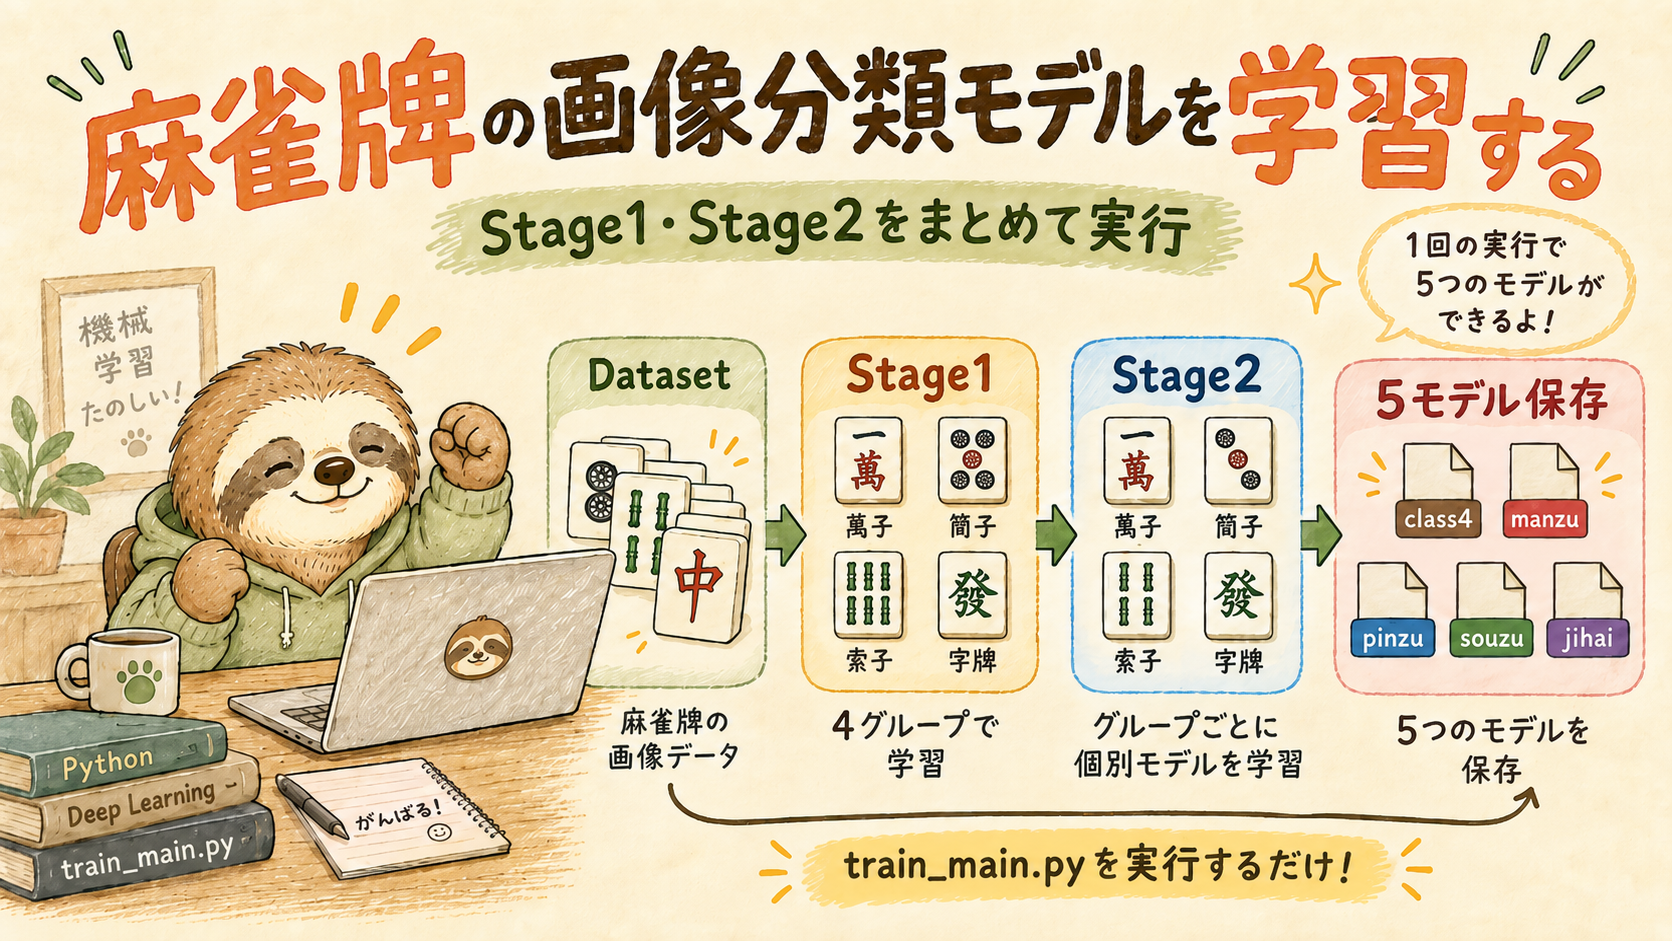
今回は、そのTrainerを使ってStage1とStage2のモデルをまとめて学習します。
最終的に作成するモデルは、
class4.pth

manzu.pth
pinzu.pth
souzu.pth
jihai.pth
の5つです。
今回使用するコードは次のファイルです。
train_main.py の全文を見る
import train_utils.config as conf
from train_utils.augmentation import augment
from train_utils.dataset import MahjongDataset
from train_utils.trainer import ImageClassifierTrainer

from datetime import datetime


def main():
    # 1. augmentation
    augment()

    # 学習
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    RESULT_PATH = f"./image_classification/03_train/{timestamp}"

    # 2. stage1
    trainer = ImageClassifierTrainer(
        train_dataset=MahjongDataset(root_dir=conf.DATASET_PATH, split="train", task="class4",),
        val_dataset=MahjongDataset(root_dir=conf.DATASET_PATH, split="val", task="class4",),
        test_dataset=MahjongDataset(root_dir=conf.DATASET_PATH, split="test", task="class4",),
        output_model=f"{RESULT_PATH}/class4.pth",
        epochs=3,
    )
    trainer.train()

    # 3. stage2
    for group in MahjongDataset.GROUPS.keys():
        trainer = ImageClassifierTrainer(
            train_dataset=MahjongDataset(root_dir=conf.DATASET_PATH, split="train", task="stage2",group=group,),
            val_dataset=MahjongDataset(root_dir=conf.DATASET_PATH, split="val", task="stage2",group=group,),
            test_dataset=MahjongDataset(root_dir=conf.DATASET_PATH, split="test", task="stage2",group=group,),
            output_model=f"{RESULT_PATH}/{group}.pth",
            epochs=5,
        )
        trainer.train()


if __name__ == "__main__":
    main()
これまで作ってきた、
config.py
augmentation.py
dataset.py
trainer.py
を、ここで初めてまとめて実行します。
全体の流れは、
データ拡張
↓
Stage1を学習
↓
Stage2 萬子を学習
↓
Stage2 筒子を学習
↓
Stage2 索子を学習
↓
Stage2 字牌を学習
↓
5つのモデルを保存
です。
最初に学習データを作る
まず最初に、
augment()を実行します。
これは以前の記事で作ったaugmentation.pyの処理です。
保存してあるcorrect・miss画像から、
train
val
test
に分割した学習データを作ります。
出力先はconfig.pyで作られた、
DATASET_PATHです。
つまり、
元の牌画像
↓
augment()
↓
train / val / test
↓
モデル学習
までを1回の実行で進められるようにしています。
学習結果は実行ごとに別フォルダへ保存する
モデルの保存先には日時を使っています。
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
RESULT_PATH = f"./image_classification/03_train/{timestamp}"
例えば、
03_train
└── 20260921_153000
のようなフォルダが作られます。
再学習しても以前のモデルを上書きせず、
いつ学習したモデルなのかを分けて管理できます。
Stage1の4分類モデルを学習する
まずStage1です。
trainer = ImageClassifierTrainer(
    train_dataset=MahjongDataset(
        root_dir=conf.DATASET_PATH,
        split="train",
        task="class4",
    ),
    val_dataset=MahjongDataset(
        root_dir=conf.DATASET_PATH,
        split="val",
        task="class4",
    ),
    test_dataset=MahjongDataset(
        root_dir=conf.DATASET_PATH,
        split="test",
        task="class4",
    ),
    output_model=f"{RESULT_PATH}/class4.pth",
    epochs=3,
)

trainer.train()
前回作ったDatasetへ、
task="class4"を指定しています。
これによって、
萬子
筒子
索子
字牌
の4分類モデルを学習します。
保存されるモデルは、
class4.pthです。
現在の設定ではStage1を3 Epoch学習します。
Stage2は4つのモデルを順番に学習する
Stage2では、
for group in MahjongDataset.GROUPS.keys():としてグループを順番に処理します。
GROUPSには、
manzu
pinzu
souzu
jihai
が登録されているため、4回学習が実行されます。
Datasetには、
task="stage2",
group=group,
を指定します。
例えばgroup="pinzu"なら、
筒子の画像だけを使う
↓
筒子の牌種類を分類する
Datasetになります。
Stage2は現在、
epochs=5として5 Epochずつ学習しています。
最終的に5つのモデルが完成する
すべての学習が終了すると、結果フォルダは次のようになります。
03_train
└── 20260921_153000
    ├── class4.pth
    ├── manzu.pth
    ├── pinzu.pth
    ├── souzu.pth
    └── jihai.pth
役割は、
class4.pth
↓
萬子 / 筒子 / 索子 / 字牌を判定

manzu.pth
↓
萬子の中から牌を判定

pinzu.pth
↓
筒子の中から牌を判定

souzu.pth
↓
索子の中から牌を判定

jihai.pth
↓
字牌の中から牌を判定
です。
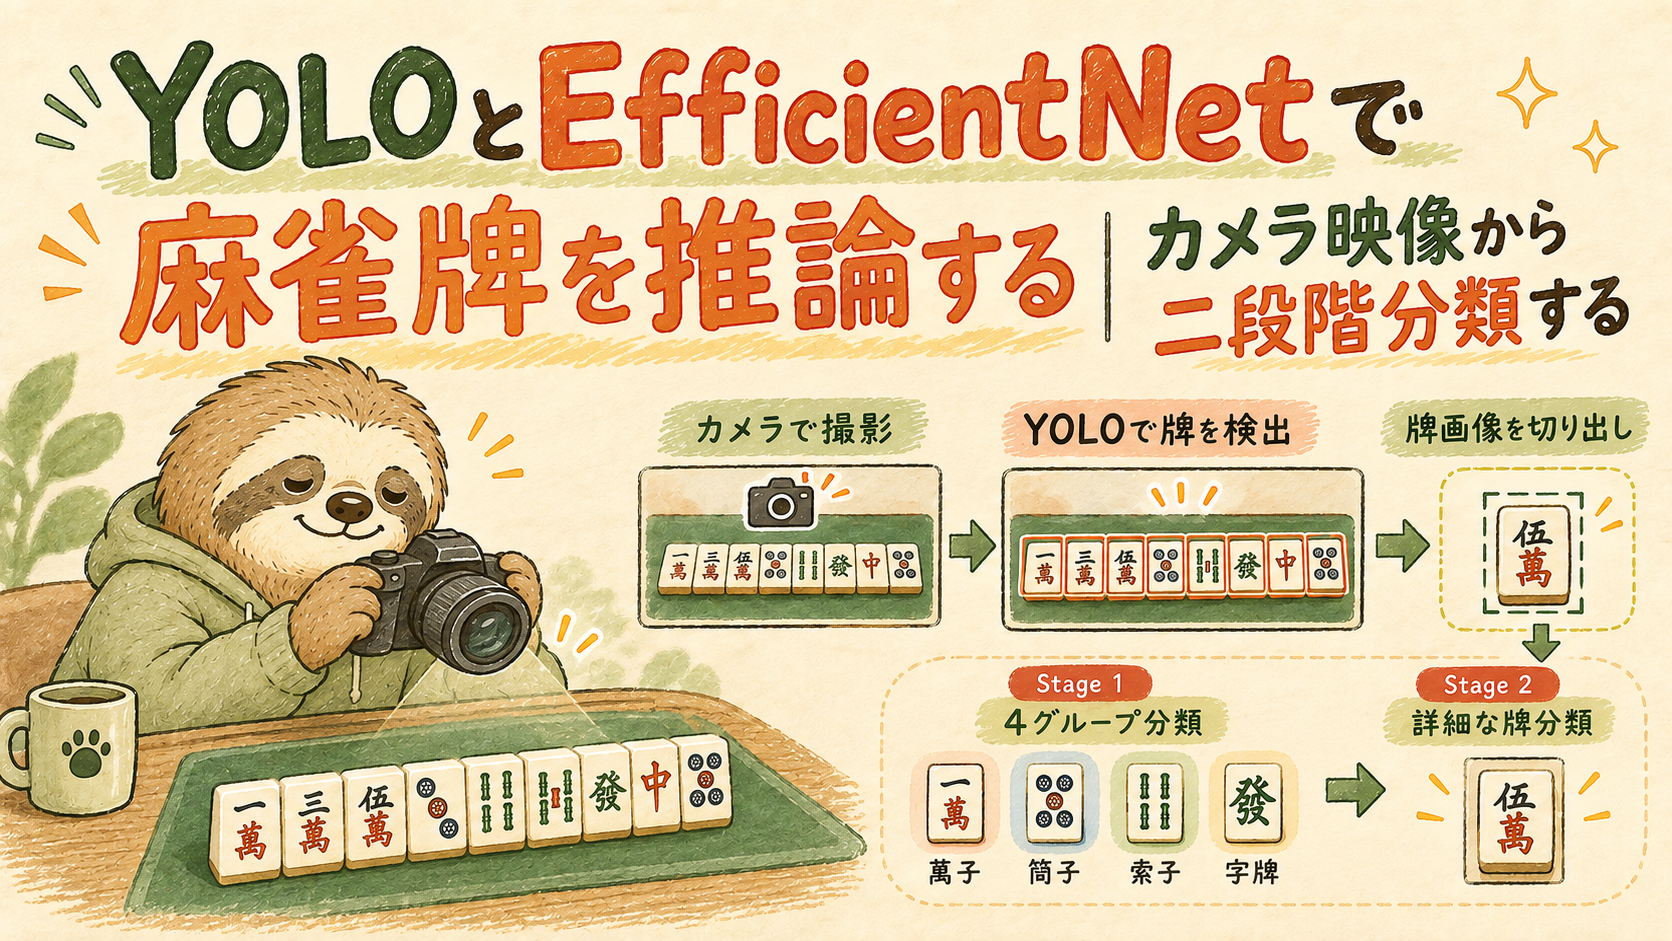
実際の推論では、
Stage1
↓
どのグループか判定
↓
対応するStage2モデル
↓
具体的な牌を判定
という二段階で使います。
学習処理そのものはTrainerに任せる
train_main.pyには、Loss計算や誤差逆伝播などの処理は書いていません。
学習するときは、
trainer.train()を呼ぶだけです。
前回作ったImageClassifierTrainerの中で、
DataLoader
↓
EfficientNet-B0
↓
学習
↓
Validation
↓
モデル保存
↓
Test
まで処理します。
そのためtrain_main.pyの役割は、
「どのDatasetを、どの設定で学習するかを決めること」
です。
dataset.py
↓
画像とラベルを管理

trainer.py
↓
学習方法を管理

train_main.py
↓
学習全体を実行
と、それぞれ役割を分けています。
Accuracyを確認する
TrainerではEpochごとに、
train accuracy
validation accuracy
を表示します。
さらに学習終了後にはtest()が呼ばれ、
Test Accuracyも表示されます。
これによって、
学習データでは正しく分類できているか
↓
Validationでも精度が出ているか
↓
Test画像でも分類できるか
を確認できます。
まとめ
今回はtrain_main.pyを使って、Stage1とStage2の学習をまとめて実行しました。
作成されるモデルは、
class4.pth
manzu.pth
pinzu.pth
souzu.pth
jihai.pth
の5つです。
これまで別々に作ってきた、
データ拡張
Dataset
Trainer
をここでつなぎ、
画像を準備
↓
Stage1を学習
↓
Stage2を4種類学習
↓
モデルを保存
まで自動で実行できるようになりました。
次回はいよいよ、作成したモデルを実際の麻雀CPUへ組み込みます。
YOLOで牌の位置を検出して切り出した画像を、
YOLO
↓
牌画像を切り出す
↓
EfficientNet Stage1
↓
EfficientNet Stage2
↓
牌IDを決定
という流れで認識させます。
ここまで作ってきたYOLOとEfficientNetが、ようやく1つにつながります。
コメント