前回は、麻雀牌画像をPyTorchから読み込むためのMahjongDatasetを作りました。
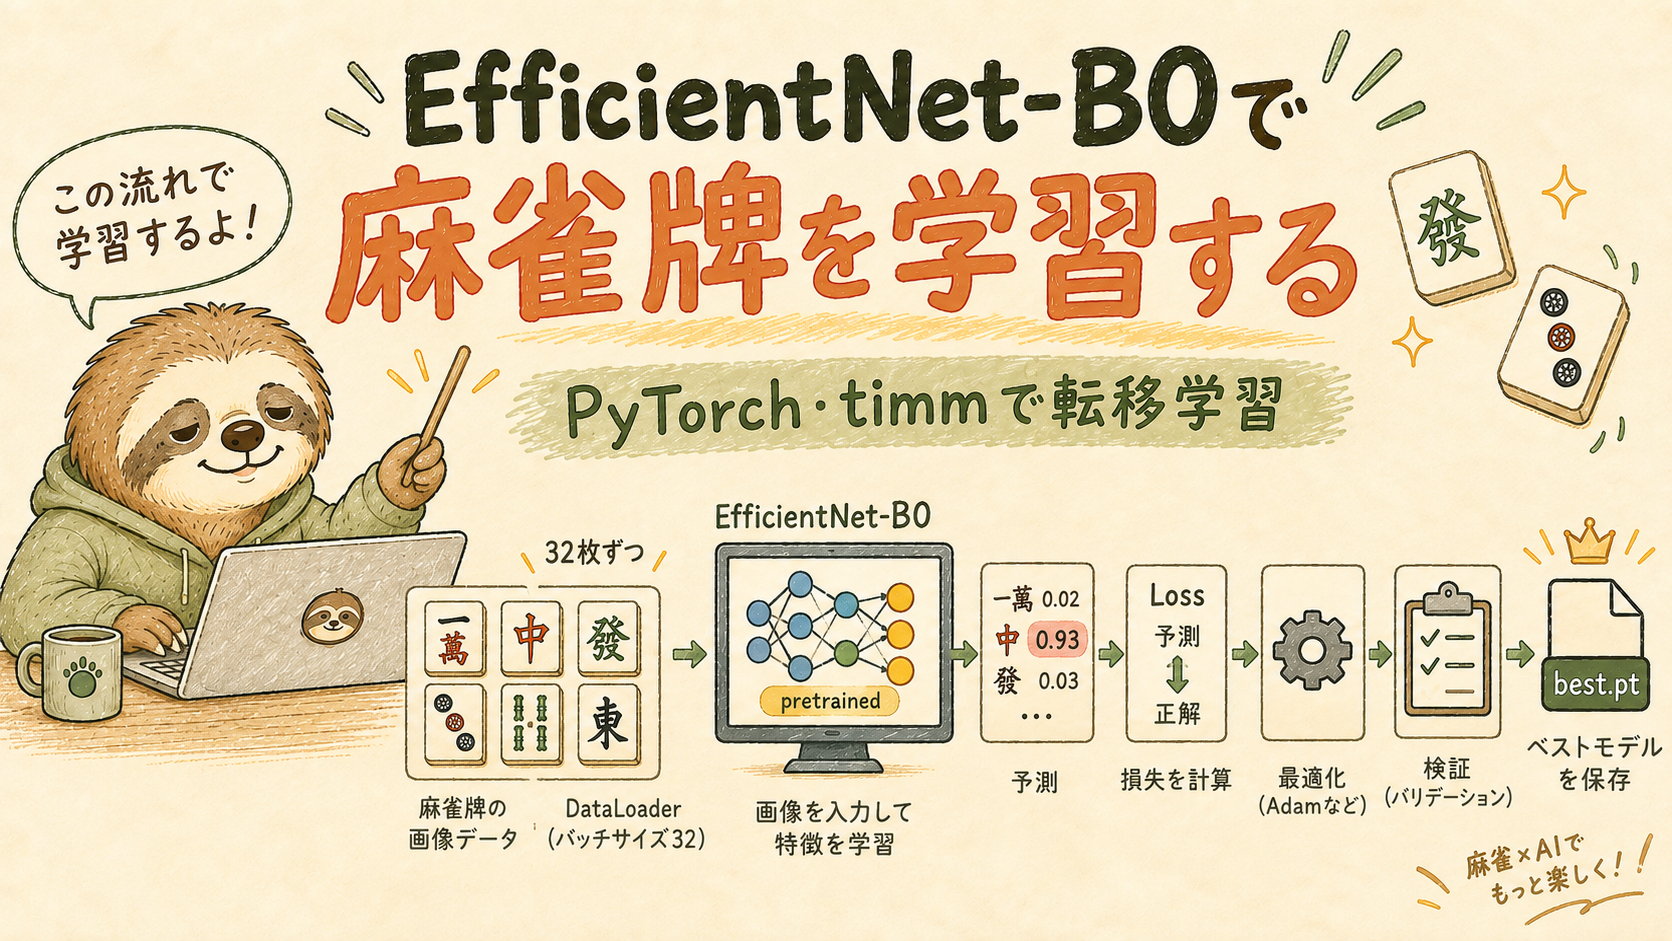
今回は、そのDatasetを使ってEfficientNet-B0を実際に学習する処理を作ります。
今回使用するコードは次のファイルです。
trainer.py の全文を見る
import timm
import torch
from torch import nn
from tqdm import tqdm
from pathlib import Path
import torch.nn.functional as F
from torch.utils.data import DataLoader
from torchvision import transforms
from sklearn.metrics import accuracy_score


class ImageClassifierTrainer:
    def __init__(self, train_dataset, val_dataset, test_dataset, output_model,
                 image_size=224, batch_size=32,
                 epochs=3, lr=1e-4, device="mps",
                 model_name="efficientnet_b0"):
        self.train_dataset = train_dataset
        self.val_dataset = val_dataset
        self.test_dataset = test_dataset

        self.class_names = train_dataset.class_names

        self.num_classes = len(self.class_names)

        pin_memory = device.startswith("cuda")

        self.train_loader = DataLoader(
            train_dataset,
            batch_size=batch_size,
            shuffle=True,
            pin_memory=pin_memory,
        )

        self.val_loader = DataLoader(
            val_dataset,
            batch_size=batch_size,
            shuffle=False,
            pin_memory=pin_memory,
        )

        self.test_loader = DataLoader(
            test_dataset,
            batch_size=batch_size,
            shuffle=False,
            pin_memory=pin_memory,
        )
        self.output_model=Path(output_model)
        self.image_size=image_size
        self.batch_size=batch_size
        self.epochs=epochs
        self.lr=lr
        self.device=device
        self.train_tf=transforms.Compose([
            transforms.Resize((image_size,image_size)),
            transforms.RandomRotation(2),
            transforms.ColorJitter(0.15,0.15,0.15),
            transforms.ToTensor(),
            transforms.Normalize([0.485,0.456,0.406],[0.229,0.224,0.225])
        ])
        self.val_tf=transforms.Compose([
            transforms.Resize((image_size,image_size)),
            transforms.ToTensor(),
            transforms.Normalize([0.485,0.456,0.406],[0.229,0.224,0.225])
        ])

        self.train_dataset.transform = self.train_tf
        self.val_dataset.transform = self.val_tf
        self.test_dataset.transform = self.val_tf

        self.model = timm.create_model(model_name, pretrained=True, num_classes=self.num_classes,).to(device)

        self.criterion=nn.CrossEntropyLoss()
        self.optimizer=torch.optim.AdamW(self.model.parameters(),lr=self.lr)
        self.scheduler=torch.optim.lr_scheduler.CosineAnnealingLR(self.optimizer,T_max=self.epochs)

    def _run_epoch(self, train=True):
        self.model.train(train)
        loader=self.train_loader if train else self.val_loader
        preds=[]; labels=[]; loss_sum=0
        ctx=torch.enable_grad() if train else torch.no_grad()
        with ctx:
            for x,y in tqdm(loader, leave=False):
                x,y=x.to(self.device),y.to(self.device)
                if train: self.optimizer.zero_grad()
                out=self.model(x)
                loss=self.criterion(out,y)
                if train:
                    loss.backward(); self.optimizer.step()
                loss_sum+=loss.item()
                preds.extend(out.argmax(1).cpu().tolist())
                labels.extend(y.cpu().tolist())
        return loss_sum/len(loader), accuracy_score(labels,preds)

    def train(self):
        best=0
        for e in range(self.epochs):
            tl,ta=self._run_epoch(True)
            vl,va=self._run_epoch(False)
            self.scheduler.step()
            print(f"Epoch {e+1}: train {ta:.4f} val {va:.4f}")
            if va>best:
                best=va
                self.output_model.parent.mkdir(parents=True,exist_ok=True)
                torch.save({"model_state_dict":self.model.state_dict(),
                            "class_names":self.class_names}, self.output_model)

        print("Best:",best)
        if self.test_dataset is not None:
            self.test()

    @torch.no_grad()
    def test(self):
        self.model.eval()
        rows = []
        correct = 0
        for batch_idx, (images, labels) in enumerate(self.test_loader):
            images = images.to(self.device)
            outputs = self.model(images)
            probs = F.softmax(outputs, dim=1)
            preds = probs.argmax(dim=1).cpu()
            labels = labels.cpu()

            for i in range(len(preds)):
                pred_idx = preds[i].item()
                label_idx = labels[i].item()
                gt = self.class_names[label_idx]
                pred = self.class_names[pred_idx]
                ok = gt == pred
                if ok:
                    correct += 1

                sample_idx = batch_idx * self.batch_size + i
                image_path = str(
                    self.test_dataset.samples[sample_idx][0]
                )
                row = {
                    "image": image_path,
                    "ground_truth": gt,
                    "prediction": pred,
                    "correct": ok,
                }

                for c, class_name in enumerate(self.class_names):
                    row[f"prob_{class_name}"] = float(probs[i, c])

                rows.append(row)

        accuracy = correct / len(self.test_dataset)
        print(f"Test Accuracy : {accuracy:.4f}")
なお、trainer.pyは単体で実行するファイルではありません。
今回の処理は、
MahjongDataset
↓
DataLoader
↓
EfficientNet-B0
↓
学習・検証
↓
モデル保存
という流れで,
後の記事で紹介するtrain_main.pyから呼び出して使用します。
学習処理をTrainerクラスにまとめる
今回も処理をバラバラの関数にはせず、
class ImageClassifierTrainer:というクラスにまとめています。
Trainerには、
Dataset
DataLoader
モデル
Loss
Optimizer
Scheduler
保存先
など、学習に必要な情報をまとめて持たせます。
これによって最終的には、
trainer = ImageClassifierTrainer(...)
trainer.train()
だけで学習できる形になります。
また、Stage1とStage2で同じTrainerを使い回せるのもメリットです。
DataLoaderで画像をまとめて読み込む
PyTorchでは、Datasetから画像を直接1枚ずつ処理するのではなく、DataLoaderを使います。
self.train_loader = DataLoader(
    train_dataset,
    batch_size=batch_size,
    shuffle=True,
)

self.val_loader = DataLoader(
    val_dataset,
    batch_size=batch_size,
    shuffle=False,
)
今回は、
batch_size=32なので、32枚ずつまとめて学習します。
学習データだけshuffle=Trueにして、Epochごとに画像の順番を変えています。
学習用と評価用でtransformを分ける
学習時の画像には、少しだけランダムな変化を加えます。
self.train_tf = transforms.Compose([
    transforms.Resize((image_size, image_size)),
    transforms.RandomRotation(2),
    transforms.ColorJitter(0.15, 0.15, 0.15),
    transforms.ToTensor(),
    transforms.Normalize(
        [0.485, 0.456, 0.406],
        [0.229, 0.224, 0.225]
    )
])
一方、ValidationとTestではランダム変換を入れません。
self.val_tf = transforms.Compose([
    transforms.Resize((image_size, image_size)),
    transforms.ToTensor(),
    transforms.Normalize(
        [0.485, 0.456, 0.406],
        [0.229, 0.224, 0.225]
    )
])前回Dataset側でtransformを外から渡せるようにしていたので、
self.train_dataset.transform = self.train_tf
self.val_dataset.transform = self.val_tf
self.test_dataset.transform = self.val_tf
としてTrainer側から設定しています。
timmからEfficientNet-B0を読み込む
モデル作成にはtimmを使います。
self.model = timm.create_model(
    model_name,
    pretrained=True,
    num_classes=self.num_classes,
).to(device)
デフォルトは、
model_name="efficientnet_b0"です。
また、
pretrained=Trueにしているため、学習済みのEfficientNet-B0をベースに麻雀牌画像で追加学習します。
学習済みEfficientNet-B0
↓
麻雀牌画像で学習
↓
麻雀牌分類モデル
これが今回使っている転移学習です。
クラス数はDatasetから取得する
Trainer側では、
self.class_names = train_dataset.class_names
self.num_classes = len(self.class_names)
としてクラス数を取得しています。
そのため、
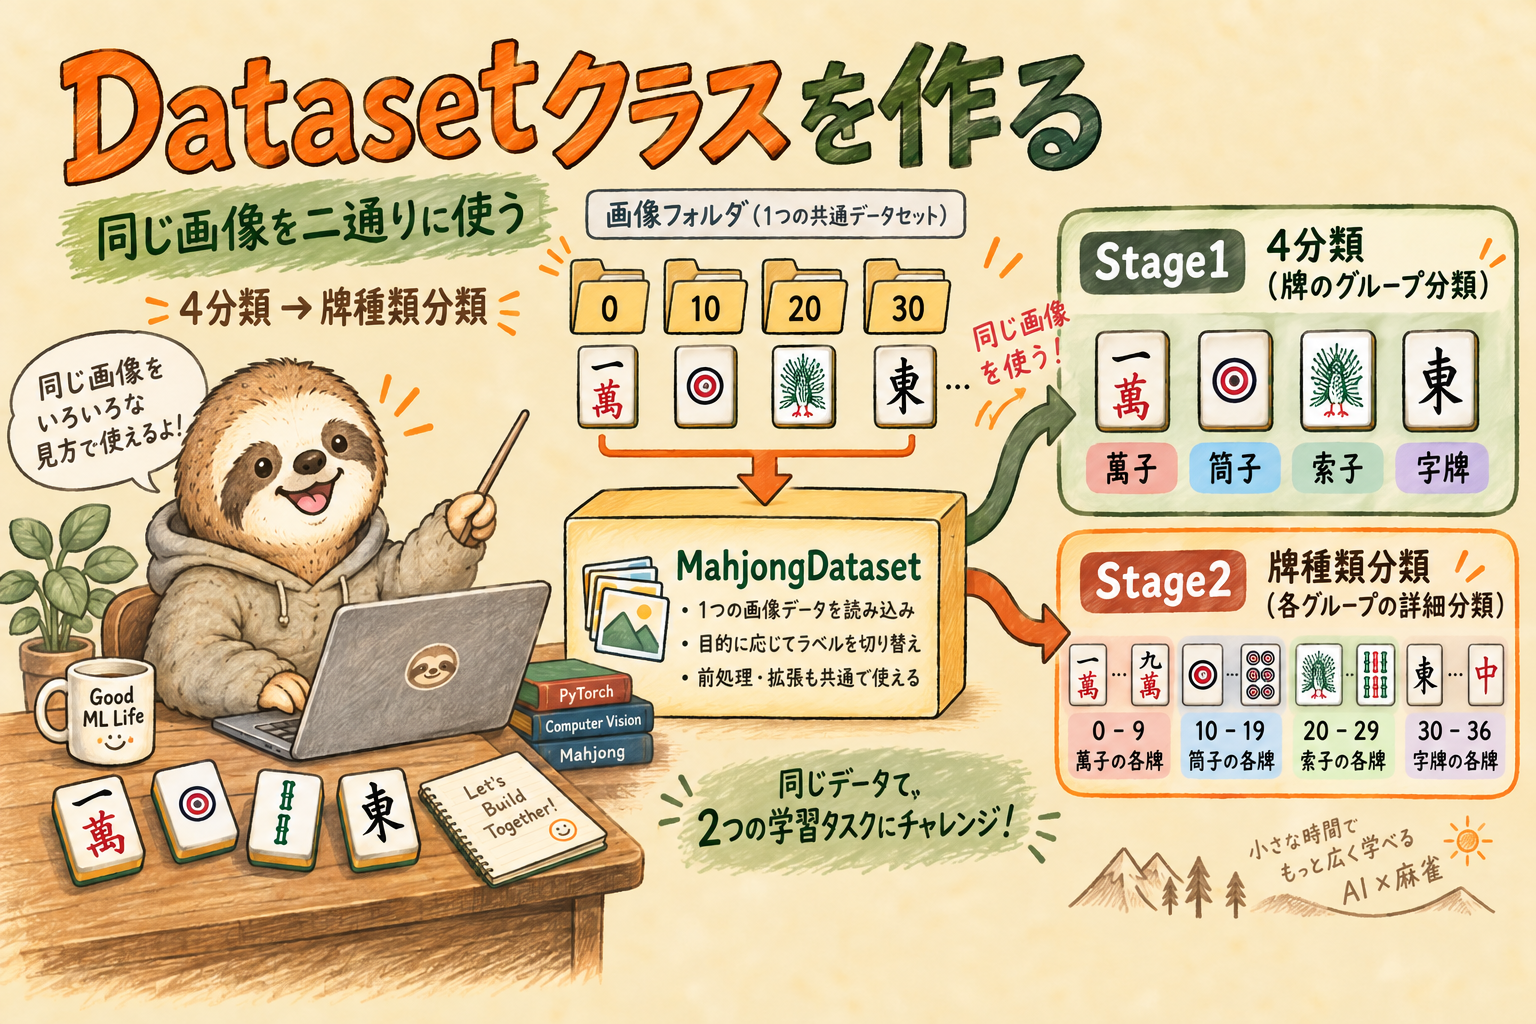
Stage1
→ 4クラス

Stage2 萬子/筒子/索子
→ 10クラス

Stage2 字牌
→ 7クラス
のような違いをTrainer側で個別に設定する必要がありません。
Datasetを入れ替えるだけで、出力クラス数も自動で変わります。
Loss・Optimizer・Schedulerを設定する
損失関数には、
self.criterion = nn.CrossEntropyLoss()Optimizerには、
self.optimizer = torch.optim.AdamW(
    self.model.parameters(),
    lr=self.lr
)
を使用しています。
さらに、
self.scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(
    self.optimizer,
    T_max=self.epochs
)
で、学習が進むにつれて学習率を少しずつ小さくしています。
学習とValidationを繰り返す
1Epoch分の処理は、
def _run_epoch(self, train=True):にまとめています。
学習時は、
画像を入力
↓
予測
↓
Loss計算
↓
誤差逆伝播
↓
重み更新
という流れです。
コードでは、
out = self.model(x)
loss = self.criterion(out, y)

loss.backward()
self.optimizer.step()
となります。
Validation時はモデルを更新しないため、torch.no_grad()を使います。
一番良いモデルだけ保存する
各EpochでValidation Accuracyを確認し、
if va > best:のときだけモデルを保存します。
torch.save(
    {
        "model_state_dict":
            self.model.state_dict(),
        "class_names":
            self.class_names
    },
    self.output_model
)
保存するのは、
モデルの重み
+
class_names
です。
class_namesも保存しておくことで、推論時にモデル出力を牌IDへ戻しやすくしています。
Trainerを共通化するメリット
今回Trainerをクラス化したことで、
Stage1
4分類

Stage2
萬子
筒子
索子
字牌
すべてで同じ学習処理を使えます。
違うのは、渡すDatasetと保存先だけです。
Datasetを変更
↓
同じTrainer
↓
別のモデルを学習
という構成です。
まとめ
今回は、ImageClassifierTrainerを使ってEfficientNet-B0を学習する処理を作りました。
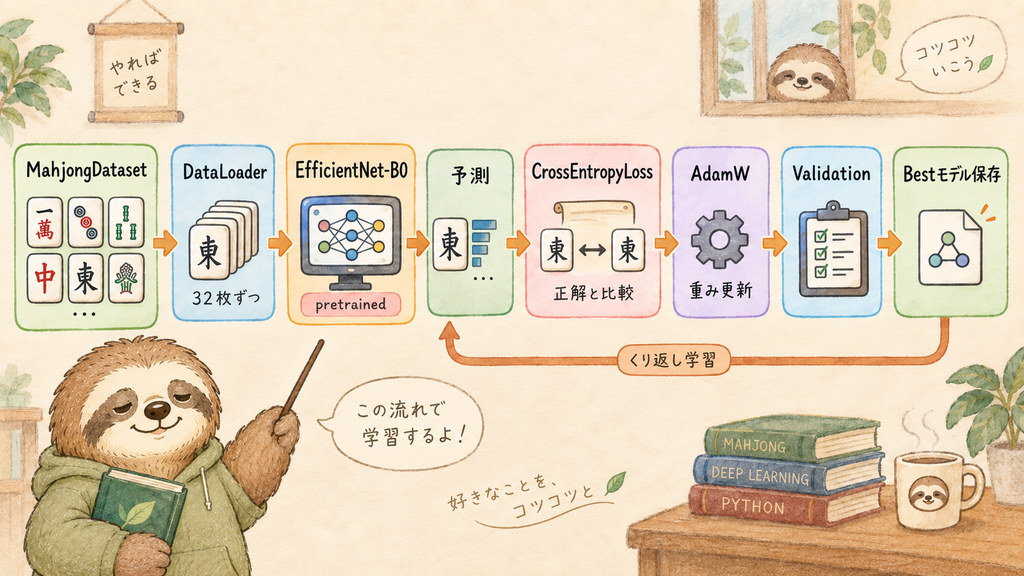
全体の流れは、
MahjongDataset
↓
DataLoader
↓
EfficientNet-B0
↓
CrossEntropyLoss
↓
AdamW
↓
学習・Validation
↓
Bestモデルを保存
です。
前回のDatasetと今回のTrainerを分けたことで、
画像とラベルの管理
↓
MahjongDataset

学習処理
↓
ImageClassifierTrainer
と役割を分離できました。
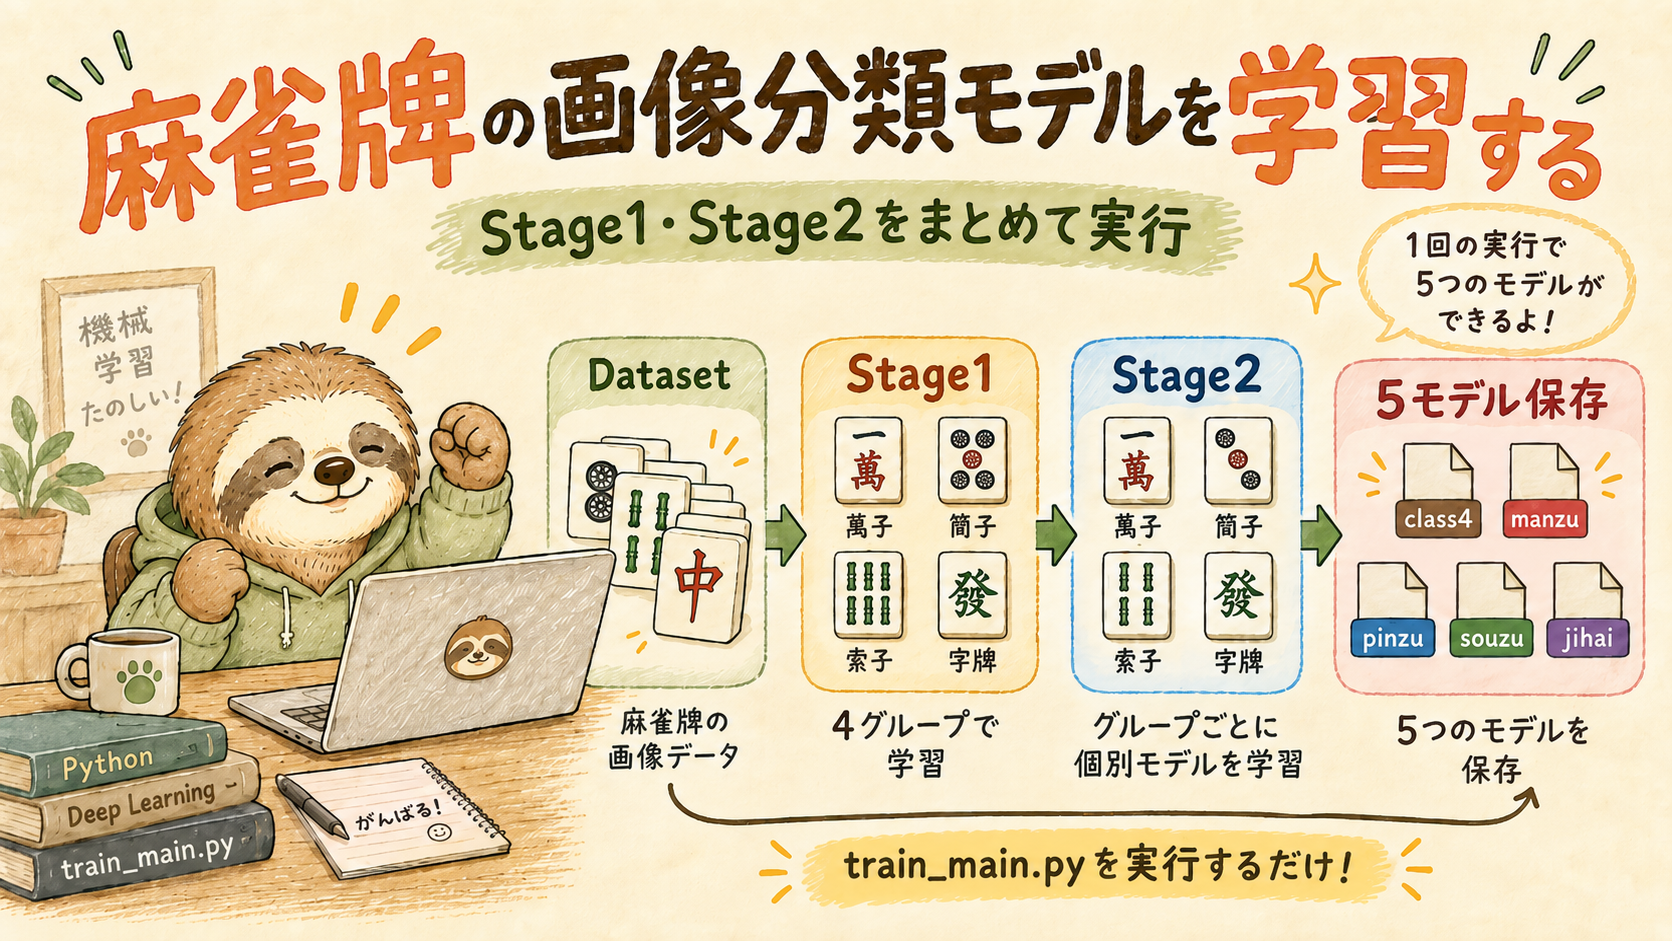
次回は、このTrainerを使ってStage1とStage2をまとめて学習する、
train_main.pyを見ていきます。
最終的には、
class4.pth
manzu.pth
pinzu.pth
souzu.pth
jihai.pth
の5つのモデルをまとめて作ります。
コメント