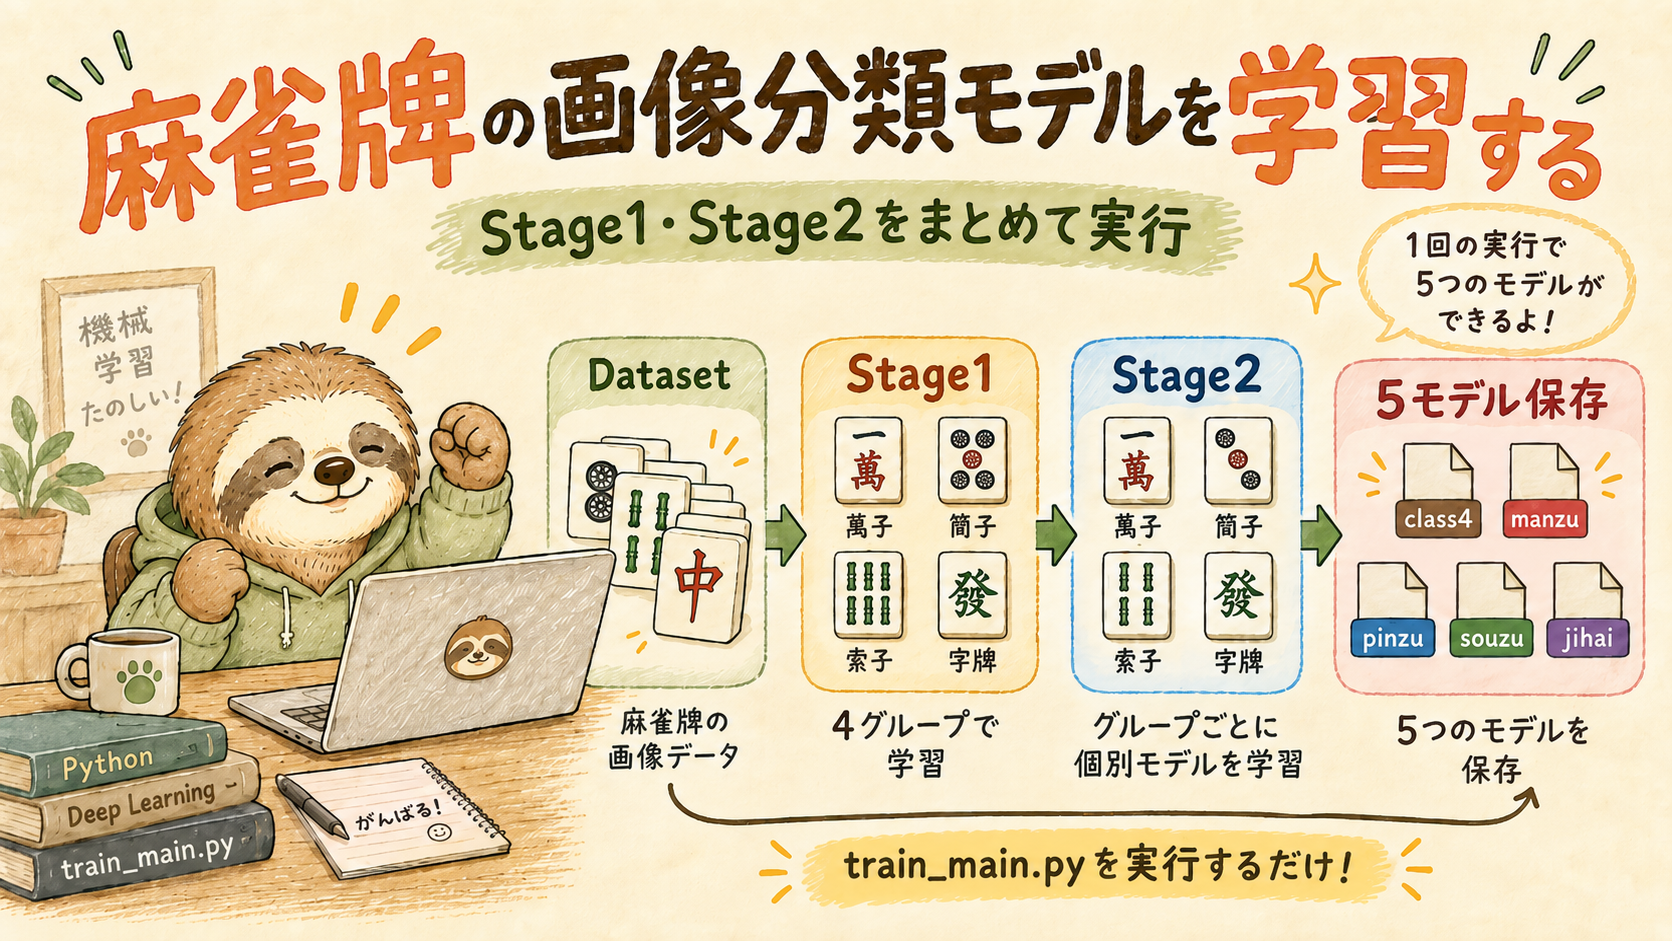
前回は、train_main.pyを使ってStage1とStage2をまとめて学習し、
class4.pth

manzu.pth
pinzu.pth
souzu.pth
jihai.pth
の5つのEfficientNetモデルを作成しました。
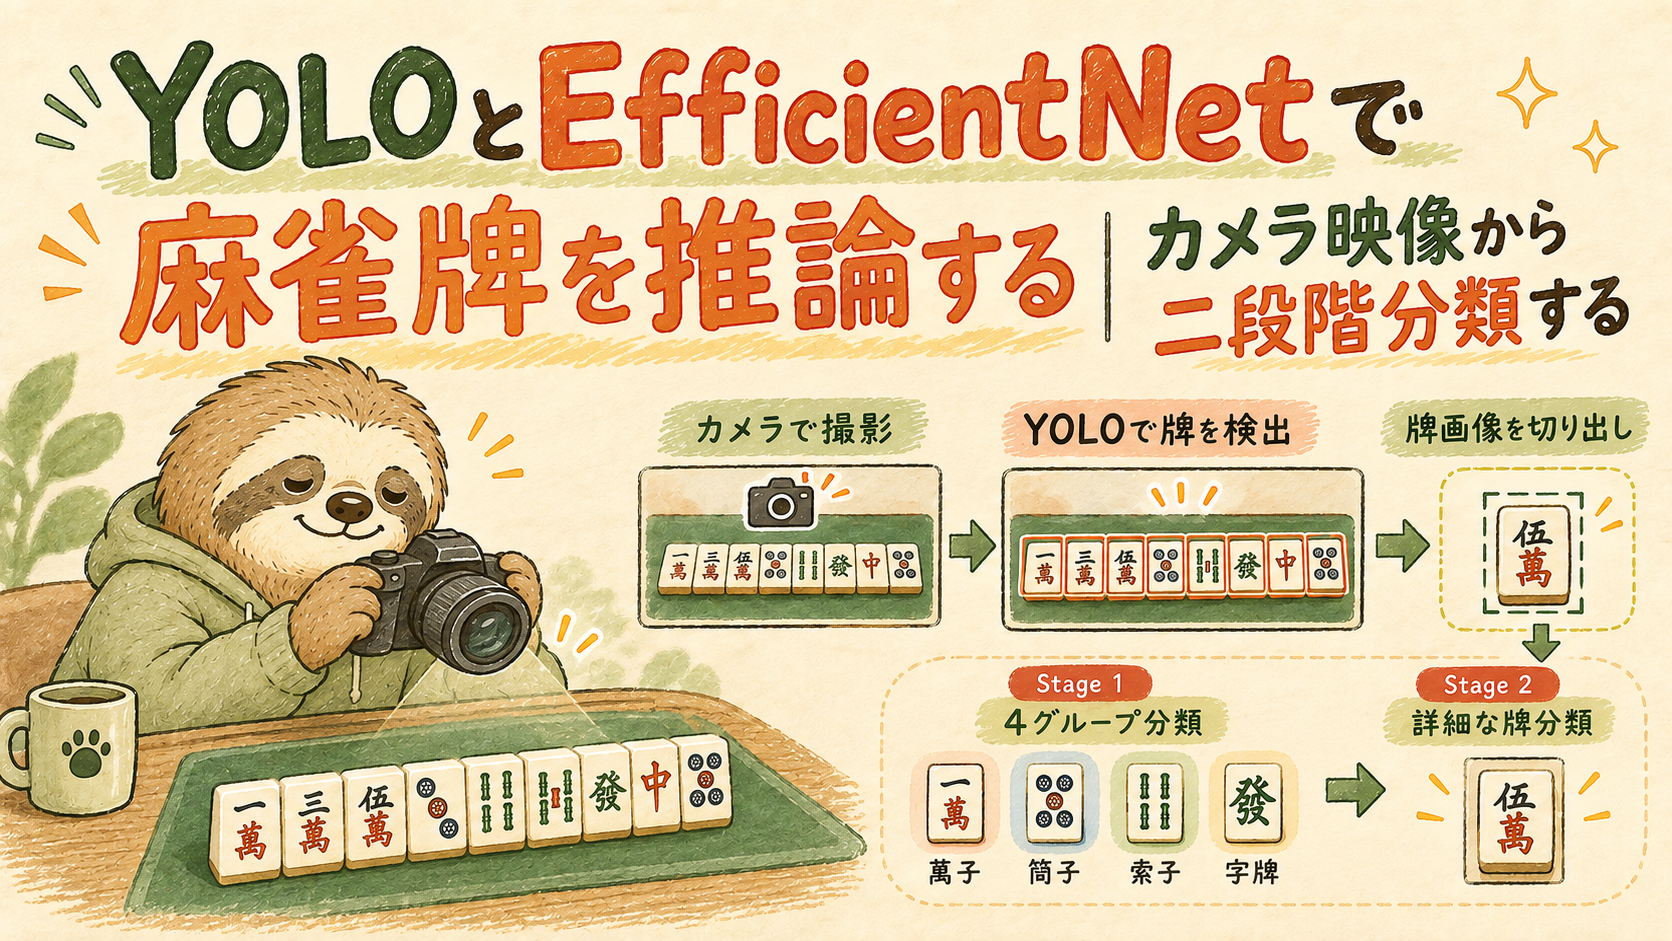
今回は、作成したモデルとYOLOを組み合わせて、カメラに映した実際の麻雀牌を推論します。
今回の流れは、
カメラ映像
↓
Sキーを押す
↓
その瞬間のフレームを取得
↓
YOLOで牌の位置を検出
↓
牌画像を切り出す
↓
EfficientNet Stage1
↓
EfficientNet Stage2
↓
牌IDを決定
↓
推論結果を表示
です。
さらに、推論した牌画像を保存する機能も入れておきます。
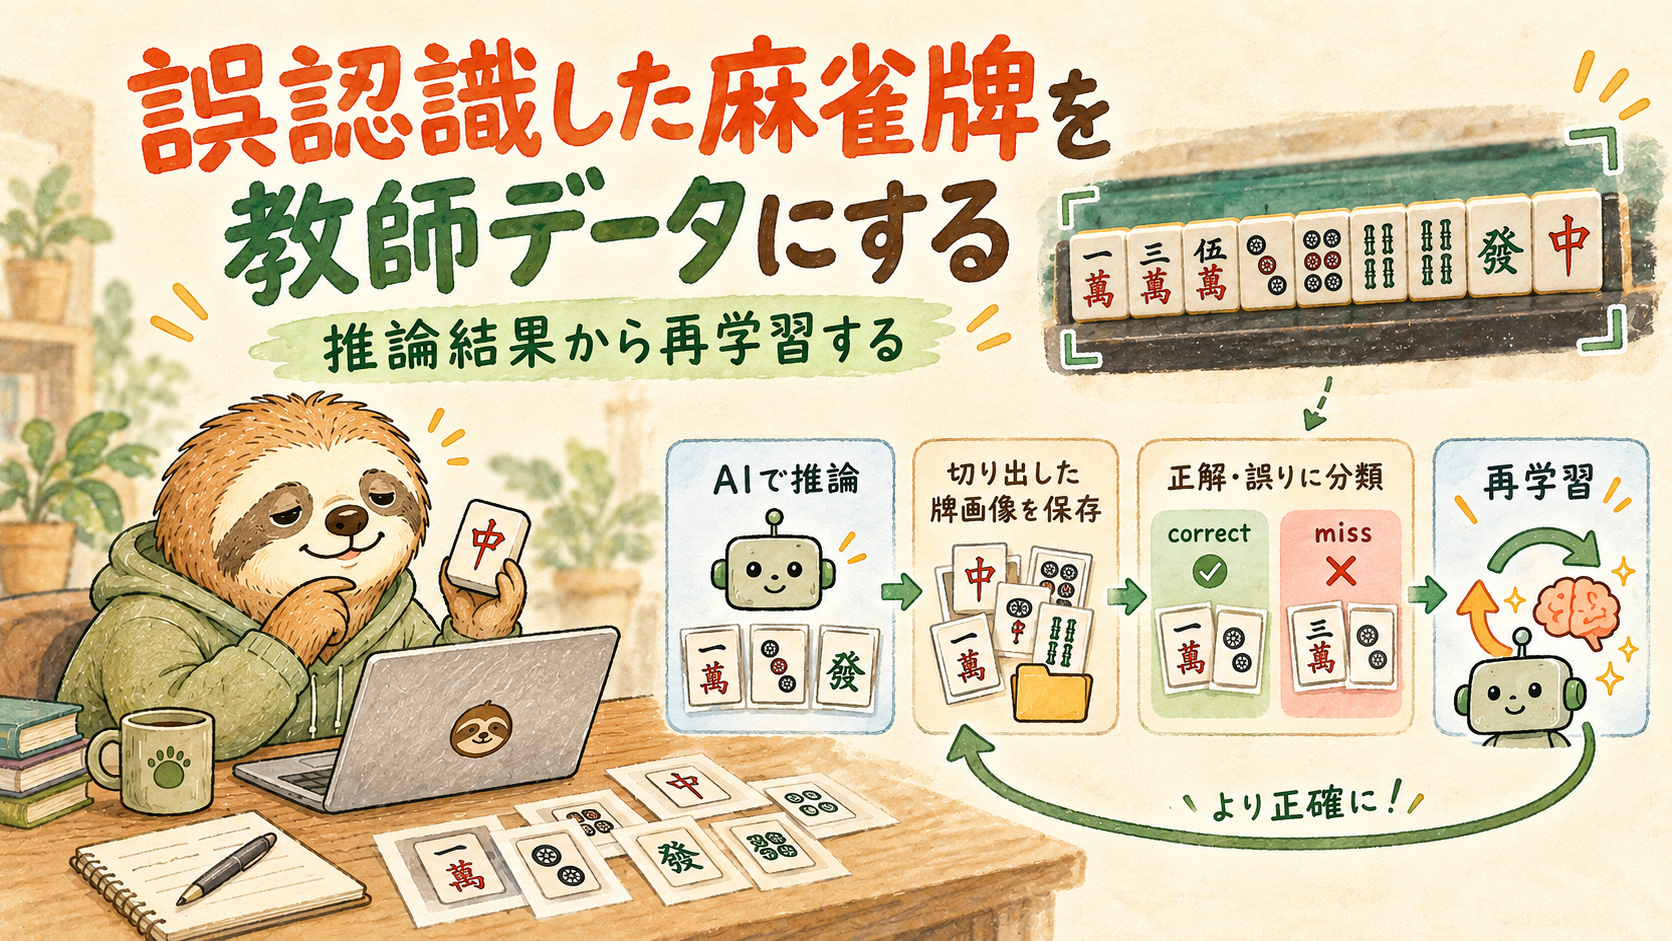
この画像は次回、correct / missに仕分けして再学習へ利用します。
今回使用するコードは次のファイルです。
inference_test.py の全文を見る
import cv2
import timm
import torch
from PIL import Image
from pathlib import Path
from ultralytics import YOLO
from datetime import datetime
from torchvision import transforms


# ==================================================
# 設定
# ==================================================
YOLO_MODEL_PATH = Path("./models/best.pt")
CLASSIFICATION_MODEL_DIR = Path("./models/20260729_220942")
RESULT_IMAGE_PATH = Path("./result.jpg")

SAVE_SAMPLES = True
SAMPLE_DIR = Path("./samples/uncheck")

YOLO_IMAGE_SIZE = 640
YOLO_CONFIDENCE = 0.5

STAGE2_FILENAMES = {
    "manzu": "manzu.pth",
    "pinzu": "pinzu.pth",
    "souzu": "souzu.pth",
    "jihai": "jihai.pth",
}

TILE_NAMES = {
    0: "1萬", 1: "2萬", 2: "3萬", 3: "4萬", 4: "5萬", 5: "6萬", 6: "7萬", 7: "8萬", 8: "9萬", 9: "赤5萬",
    10: "1筒", 11: "2筒", 12: "3筒", 13: "4筒", 14: "5筒", 15: "6筒", 16: "7筒", 17: "8筒", 18: "9筒", 19: "赤5筒",
    20: "1索", 21: "2索", 22: "3索", 23: "4索", 24: "5索", 25: "6索", 26: "7索", 27: "8索", 28: "9索", 29: "赤5索",
    30: "東", 31: "南", 32: "西", 33: "北", 34: "白", 35: "發", 36: "中",
}


def select_device():
    if torch.backends.mps.is_available():
        return "mps"
    if torch.cuda.is_available():
        return "cuda"
    return "cpu"


def load_checkpoint(path, device):
    return torch.load(path, map_location=device, weights_only=False)


class TorchImageClassifier:
    def __init__(self, checkpoint_path, device):
        checkpoint = load_checkpoint(checkpoint_path, device)
        self.class_names = [str(value) for value in checkpoint["class_names"]]
        self.model = timm.create_model("efficientnet_b0", pretrained=False, num_classes=len(self.class_names))
        self.model.load_state_dict(checkpoint["model_state_dict"])
        self.model = self.model.to(device)
        self.model.eval()
        self.device = device

    def predict(self, tensor):
        batch = tensor.unsqueeze(0).to(self.device)
        with torch.no_grad():
            outputs = self.model(batch)
            probabilities = torch.softmax(outputs, dim=1)
            confidence, predicted = torch.max(probabilities, dim=1)
        return self.class_names[predicted.item()], confidence.item()


class HierarchicalTileClassifier:
    def __init__(self, model_dir, device):
        self.stage1 = TorchImageClassifier(model_dir / "class4.pth", device)
        self.stage2 = {
            group: TorchImageClassifier(model_dir / filename, device)
            for group, filename in STAGE2_FILENAMES.items()
        }
        self.transform = transforms.Compose([
            transforms.Resize((224, 224)),
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225]),
        ])

    def classify(self, crop_image):
        rgb = cv2.cvtColor(crop_image, cv2.COLOR_BGR2RGB)
        tensor = self.transform(Image.fromarray(rgb))
        group, stage1_conf = self.stage1.predict(tensor)
        tile_name, stage2_conf = self.stage2[group].predict(tensor)
        tile_id = int(tile_name)
        confidence = stage1_conf * stage2_conf

        return {
            "tile_id": tile_id,
            "group": group,
            "stage1_conf": stage1_conf,
            "stage2_conf": stage2_conf,
            "confidence": confidence,
        }


def detect_tiles(image, yolo_model, classifier, device):
    results = yolo_model.predict(
        source=image,
        imgsz=YOLO_IMAGE_SIZE,
        conf=YOLO_CONFIDENCE,
        device=device,
        verbose=False,
    )

    detections = []
    boxes = results[0].boxes

    if boxes is not None:
        for box in boxes:
            x1, y1, x2, y2 = [int(value) for value in box.xyxy[0].tolist()]
            detections.append((x1, y1, x2, y2))

    detections.sort(key=lambda box: box[0])
    predictions = []

    for x1, y1, x2, y2 in detections:
        crop = image[y1:y2, x1:x2]
        if crop.size == 0:
            continue

        prediction = classifier.classify(crop)
        prediction["box"] = (x1, y1, x2, y2)
        prediction["crop"] = crop.copy()
        predictions.append(prediction)

    return predictions


def save_samples(predictions):
    SAMPLE_DIR.mkdir(parents=True, exist_ok=True)
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S_%f")

    for index, prediction in enumerate(predictions, start=1):
        tile_id = prediction["tile_id"]
        filename = f"{tile_id}_{timestamp}_{index:02d}.jpg"
        cv2.imwrite(str(SAMPLE_DIR / filename), prediction["crop"])


def draw_result(image, predictions):
    result = image.copy()

    for prediction in predictions:
        x1, y1, x2, y2 = prediction["box"]
        tile_id = prediction["tile_id"]
        confidence = prediction["confidence"]

        cv2.rectangle(result, (x1, y1), (x2, y2), (0, 255, 0), 2)
        cv2.putText(
            result,
            f"ID:{tile_id} {confidence:.2f}",
            (x1, max(20, y1 - 5)),
            cv2.FONT_HERSHEY_SIMPLEX,
            0.6,
            (0, 255, 0),
            2,
            cv2.LINE_AA,
        )

    return result


def run_inference(frame, yolo_model, classifier, device):
    predictions = detect_tiles(frame, yolo_model, classifier, device)

    print(f"\n検出枚数: {len(predictions)}")
    for index, prediction in enumerate(predictions, start=1):
        tile_id = prediction["tile_id"]
        tile_name = TILE_NAMES[tile_id]
        print(
            f"{index:02d}: ID={tile_id:02d} {tile_name} / "
            f"Stage1={prediction['group']} ({prediction['stage1_conf']:.3f}) / "
            f"Stage2={prediction['stage2_conf']:.3f} / "
            f"Final={prediction['confidence']:.3f}"
        )

    if SAVE_SAMPLES:
        save_samples(predictions)
        print(f"サンプル保存: {SAMPLE_DIR}")

    result = draw_result(frame, predictions)
    cv2.imwrite(str(RESULT_IMAGE_PATH), result)
    return result


def main():
    device = select_device()
    print(f"device: {device}")

    yolo_model = YOLO(str(YOLO_MODEL_PATH))
    classifier = HierarchicalTileClassifier(CLASSIFICATION_MODEL_DIR, device)

    camera = cv2.VideoCapture(0)
    if not camera.isOpened():
        raise RuntimeError(f"カメラを開けません: {0}")

    print("Sキー: 推論")
    print("Qキー: 終了")

    try:
        while True:
            ret, frame = camera.read()
            if not ret:
                print("カメラ画像を取得できませんでした")
                break

            preview = frame.copy()
            cv2.putText(preview, "S: inference  Q: quit", (20, 35), cv2.FONT_HERSHEY_SIMPLEX, 0.8,(0, 0, 0),5,cv2.LINE_AA,)

            cv2.imshow("Camera", preview)
            key = cv2.waitKey(1) & 0xFF
            if key in (ord("q"), ord("Q")):
                break
            if key in (ord("s"), ord("S")):
                run_inference(frame.copy(), yolo_model, classifier, device)

    finally:
        camera.release()
        cv2.destroyAllWindows()


if __name__ == "__main__":
main()使用するモデルを設定する
最初にYOLOとEfficientNetのモデルを指定します。
YOLO_MODEL_PATH = Path("./models/best.pt")
CLASSIFICATION_MODEL_DIR = Path("./models/20260729_220942")
分類モデルのフォルダには、
20260729_220942
├── class4.pth
├── manzu.pth
├── pinzu.pth
├── souzu.pth
└── jihai.pth
を置いています。
また、
SAVE_SAMPLES = True
SAMPLE_DIR = Path("./samples/uncheck")
として、推論時に切り出した牌画像も保存するようにしています。
カメラ映像を読み込む
今回は画像ファイルを読み込むのではなく、OpenCVでカメラを起動します。
camera = cv2.VideoCapture(0)0は使用するカメラ番号です。
カメラからはループ内で、
ret, frame = camera.read()としてフレームを取得します。
取得した映像は、
cv2.imshow("Camera", preview)でリアルタイム表示します。
この時点ではまだYOLOやEfficientNetによる推論は行っていません。
Sキーを押したときだけ推論する
キー入力は、
key = cv2.waitKey(1) & 0xFFで取得しています。
Sキーが押された場合だけ、
if key in (ord("s"), ord("S")):
    run_inference(frame.copy(), yolo_model, classifier, device)
として推論を開始します。
つまり、
カメラ映像を確認
↓
牌を並べる
↓
Sキー
↓
その瞬間のフレームを推論
という使い方です。
毎フレーム推論する必要がないため、今回のような認識テストでは処理も分かりやすくなります。
終了するときはQキーを使用します。
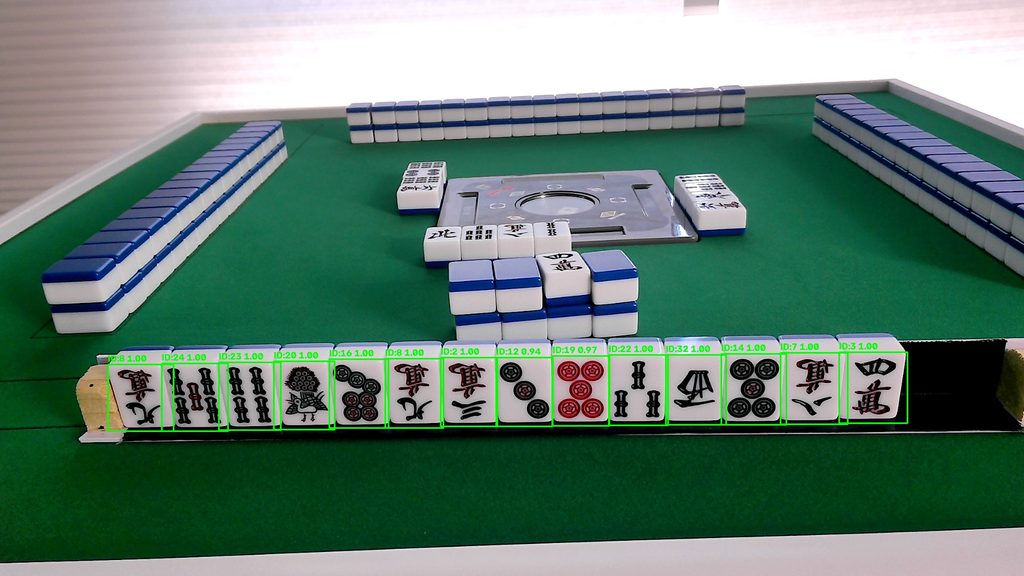
実際にSキーを押すと、このように牌ごとに検出枠が表示され、
牌IDとConfidenceを確認できます。
YOLOで牌の位置を検出する
Sキーを押すと、まずdetect_tiles()が呼ばれます。
results = yolo_model.predict(
    source=image,
    imgsz=YOLO_IMAGE_SIZE,
    conf=YOLO_CONFIDENCE,
    device=device,
    verbose=False,
)YOLOが担当するのは、牌の位置を検出することです。
結果から、
x1, y1, x2, y2 = [int(value) for value in box.xyxy[0].tolist()]として矩形座標を取得します。
さらに、
detections.sort(key=lambda box: box[0])として左から順番に並べています。
麻雀の手牌は横一列に並ぶため、これで結果も左から順番に確認できます。
検出した牌画像を切り出す
YOLOで取得した座標を使って、
crop = image[y1:y2, x1:x2]と牌の部分だけを切り出します。
流れとしては、
カメラの1フレーム
↓
YOLO
↓
牌の矩形座標
↓
牌画像をCrop
です。
このCrop画像をEfficientNetへ渡します。
Stage1で4分類する
EfficientNetへ入力する前に、
self.transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize(
        [0.485, 0.456, 0.406],
        [0.229, 0.224, 0.225],
    ),
])
として、学習時と同じ形式へ変換します。
Stage1では、
group, stage1_conf = self.stage1.predict(tensor)として、
manzu
pinzu
souzu
jihai
の4種類に分類します。
例えば1筒なら、
1筒
↓
Stage1
↓
pinzu
となります。
Stage2で具体的な牌を判定する
Stage1の結果を使って、次に使用するStage2モデルを選びます。
tile_name, stage2_conf = self.stage2[group].predict(tensor)対応は、
manzu
→ manzu.pth

pinzu
→ pinzu.pth

souzu
→ souzu.pth

jihai
→ jihai.pth
です。
例えば1筒なら、
Stage1
↓
pinzu

Stage2
↓
ID 10

結果
↓
1筒
となります。
最終的なIDは、
tile_id = int(tile_name)として取得します。
認識結果を画像として保存する
推論後は、
result = draw_result(frame, predictions)
cv2.imwrite(str(RESULT_IMAGE_PATH), result)
として結果画像を保存します。
牌の位置には矩形を描画し、
ID
Confidence
も表示します。
保存先は、
RESULT_IMAGE_PATH = Path("./result.jpg")です。
これによって、コンソールの結果だけでなく、どの牌をどの範囲で認識したのかも確認できます。
推論した牌画像も保存する
今回は今後の再学習につなげるために、YOLOで切り出した画像も保存します。
SAVE_SAMPLES = Trueの場合、
save_samples(predictions)が実行されます。
保存先は、
samples
└── uncheck
です。
例えばモデルがID 10と予測した場合、
10_20260925_120000_123456_01.jpgのような名前で保存されます。
ファイル名には、
予測した牌ID
日時
位置番号
を含めています。
なぜuncheckに保存するのか
この時点では、モデルが正しく認識できたかどうかはまだ確認していません。
例えば、
モデル予測
1筒

実際
1筒
なら正解です。
一方、
モデル予測
1筒

実際
2筒
なら誤認識です。
そのため、最初からcorrectへ入れるのではなく、
uncheckへ保存しています。
あとから人間が画像を確認して、
正しい
↓
correct

間違っている
↓
miss
へ仕分けします。
推論から再学習につなげる
今回までで、
学習済みモデル
↓
カメラから実画像を取得
↓
YOLO + EfficientNetで推論
↓
推論に使った牌画像を保存
までできるようになりました。
次に行うのは、
uncheck
↓
人間が確認
↓
correct / miss
↓
データ拡張
↓
再学習
です。
特にmissへ入る画像は、
実際の環境でモデルが間違えた画像
になります。
これを再学習に使うことで、モデルが苦手としている実画像を重点的に追加できます。
まとめ
今回はinference_test.pyを使って、カメラから麻雀牌を推論しました。
処理の流れは、
カメラ起動
↓
Sキー
↓
その瞬間のフレームを取得
↓
YOLO
牌の位置を検出
↓
Crop
↓
EfficientNet Stage1
4分類
↓
EfficientNet Stage2
牌IDを判定
↓
結果表示
です。
例えば1筒なら、
カメラ画像
↓
YOLO
↓
1筒の画像をCrop
↓
Stage1
pinzu
↓
Stage2
ID 10
↓
1筒
という流れで認識します。
さらに今回は、推論時に使用した牌画像を、
samples/uncheckへ保存するようにしました。
これによって、
学習
↓
カメラで推論
↓
実画像を保存
↓
正誤を確認
↓
再学習
という改善サイクルへつなげられます。
次回は、保存したuncheck画像を確認し、
correct
miss
へ効率よく仕分けするツールを作ります。
実際に誤認識した画像を教師データとして利用して、画像分類モデルを改善していきます。
関連記事
- 麻雀CPU、あったらいいので作ります。④ 実物の牌を認識できるのか試してみた
- YOLOモデルの作り方をゼロから解説|通常の学習手順と自動生成までの全体像
- Ultralytics YOLOを学習する|YAML設定から推論まで
- 麻雀牌を画像分類する方法|YOLO検出後にEfficientNetで牌種類を判定する
- 画像分類・EfficientNetの学習データを作る|画像分割とデータ拡張
- 麻雀牌を二段階で画像分類する|4分類→牌種類分類のDatasetを作る
- EfficientNet-B0で麻雀牌を学習する|PyTorch・timmで転移学習
- 麻雀牌の画像分類モデルを学習して精度を確認する|Stage1・Stage2をまとめて学習
コメント